
把转录特征预测放回人细胞表型检验
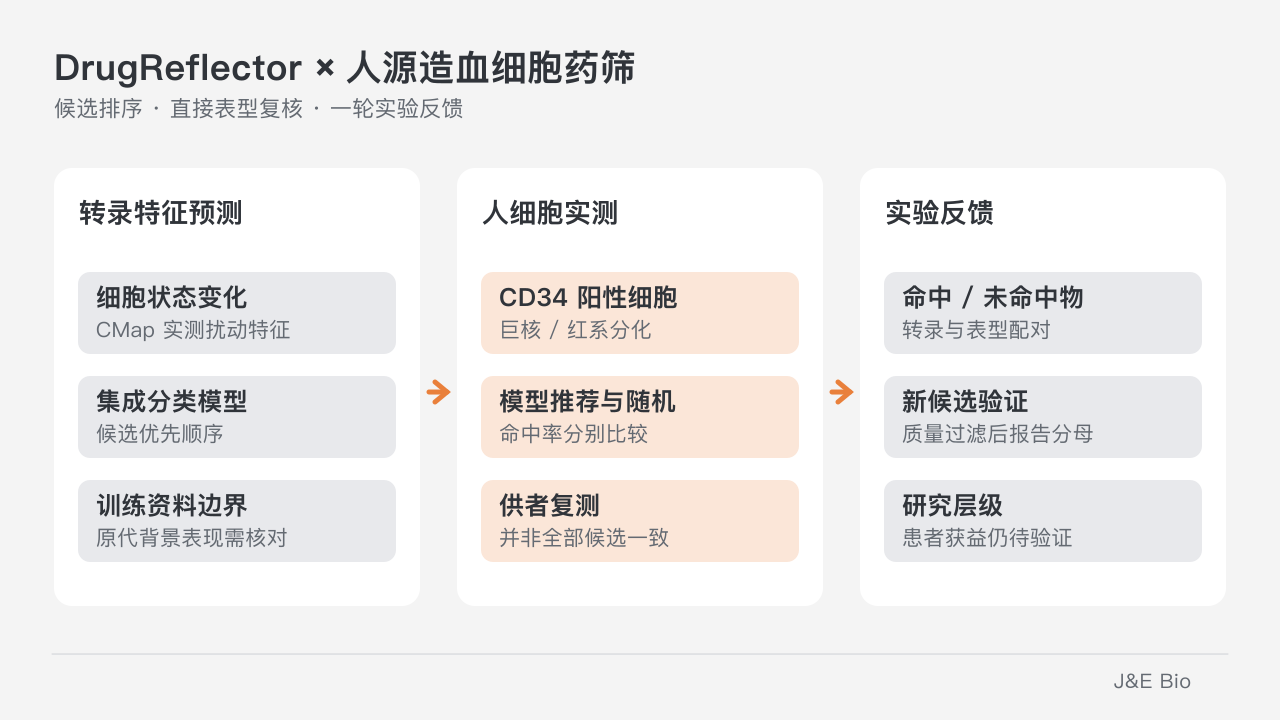
表型药筛可以同时观察多条通路对细胞行为的影响,但复杂模型往往难以大规模测试。美国 Cellarity 与德国 Helmholtz Munich 等团队开发 DrugReflector,用药物引起的转录变化给候选排序,再通过人细胞实验检查预测是否有效。
模型是 3 个多层感知器分类器的集成,以 Connectivity Map 的扰动转录特征训练。重复样本分别输入模型,不先取平均;候选排序的性能还与实验表型命中率分开评价。
研究用多个扰动数据集比较不同排序方法,并新建立覆盖 88 种化合物、10 种细胞类型的单细胞资料。癌细胞和原代细胞的表现分别分析,避免只在训练数据熟悉的背景中评价。
造血细胞分化提供具体药物筛选对象
实际药筛选用人 CD34 阳性造血干及祖细胞,目标分别是增加巨核祖细胞和红系祖细胞。输入特征来自巨核—红系祖细胞向对应谱系转变的表达差异,再用流式细胞术测量药物处理后的谱系组成。
研究先建立检测范围和阳性对照,排除活细胞数不足的条件。命中标准相对于 DMSO 对照,并考虑孔板内和孔板间的变化;主要比较使用高于对照 6 个标准差的阈值。
转录特征与流式表型提供不同信息。模型预测的是哪些化合物可能诱导相关变化,实际命中仍由细胞实验判断,随后再到其他供者中复测。
两个谱系的命中率提高,供者复测仍有差异
巨核谱系筛选中,模型推荐的 107 种化合物有 21 种命中,命中率 19.6%;随机选择的 87 种仅 1 种命中,约 1.1%。两组比值约为 17 倍,描述的是本实验的选药效率。
团队将其中 17 种命中物放到另 2 位供者中复测。2 种未满足活性或细胞数要求,在余下 15 种中,13 种在 2 位供者中都有效。这个分母与最初 21 种命中物分别报告。
红系筛选经质量过滤后,模型组 81 种有 13 种命中,随机组 85 种有 1 种,命中率比约为 13 倍。复测中 10 种通过质量过滤的候选有 8 种在至少 1 位供者有效,5 种在 2 位供者都有效,供者背景仍影响结果。
实验反馈改进特征,再测试此前未筛过的候选
主动学习阶段用 12 种命中物和 8 种未命中物,在 4 个时点检测转录变化,并配对第 7 天的表型。团队根据哪些基因变化与巨核谱系增加相关,更新最初的输入特征。
更新后,团队测试 96 种此前未筛过的新推荐物,85 种通过质量过滤,其中 22 种命中。按候选排名范围比较,前 100 名区域的命中率约提高 2 倍;实际命中物的中位排名从 463 提前到 138。
团队还将更新所得的特征打乱后重新比较,候选排序表现下降。这项对照支持实验反馈提供了与目标表型相关的信息。
输入特征影响外推,命中物也提供机制线索
加入推断的额外基因,可以提高模型在留作测试的 CMap 数据上的表现,却降低外部资料的表现。由化学结构预测的虚拟转录特征也不及实测特征,尤其在训练背景以外。
原作者指出,原代细胞背景和目标表型需要合适的扰动资料。输入特征、细胞类型、供者以及质量阈值都影响预测转化为命中的过程,后续筛选仍需直接实验复核。
命中物的转录变化还显示了不同作用途径。一类化合物共同靶向 HMGCR,与胆固醇合成调节有关;针对 KDR 的单独干预只能部分复现强效小分子的诱导作用,作者认为还涉及多个酪氨酸激酶。候选排序由此提供了可以继续检验的生物学线索。