
利用离体灌流资料建立人肺的预测模型
多伦多大学(University of Toronto)与大学健康网络(University Health Network,UHN)团队利用离体肺灌流(ex vivo lung perfusion,EVLP)资料建立数字孪生。研究将肺的物理功能计算与机器学习结合,用实际器官的基线数据预测后续功能,并探索这种预测能否充当药物比较的个体参照。论文发表于 Nature Biotechnology。
团队筛查多伦多总医院(Toronto General Hospital)2008–2024 年的 1000 例 EVLP 记录,排除 49 例资料不完整病例,纳入 951 例用于建模和分析。不同数据类型具有不同样本范围,转录组等部分资料少于 100 例。16 例接受阿替普酶(alteplase)处理的肺未用于模型训练。
离体肺在灌流与机械通气条件下提供逐次呼吸波形、每小时功能指标、灌流液分子指标、影像及组织资料。团队从气流和压力计算顺应性、气道压力及呼气量,再利用门控循环单元(gated recurrent unit,GRU)预测呼吸序列;其他功能和分子指标主要采用 XGBoost 模型。
静态与动态数字孪生采用不同的数据更新方式
静态数字孪生以基线数据预测未来时点,动态模型则利用新取得的测量不断更新。研究主要预测灌流开始后前 3 小时的变化。
模型覆盖超过 75 项指标,包括生理、灌流液生化、组学和影像特征。逐次呼吸指标的平均绝对百分比误差(mean absolute percentage error,MAPE)约为 2%–11%,每小时气体交换指标约为 4%–13%。动态模型对多项生化指标预测更好;在转录组预测中,两种模型的表现随指标变化。
不同指标的预测误差并不相同。部分炎症蛋白浓度接近零,使平均绝对百分比误差偏大;基因集富集评分及影像主成分也不是直接的临床量纲。研究另以同中心 2024–2025 年的 45 例独立人肺资料测试生理、生化与影像预测,结果与训练阶段的交叉验证表现接近。
论文还展示了 50 个依据历史资料生成的模拟肺特征组合,用于说明完整数字模型。这一模拟组与真实独立测试病例的用途不同。后续药物分析使用真实处理肺的测量及对应未处理预测,具体病例未参与模型训练。
数字模型可按资料条件使用表格、图像加表格,或进一步结合呼吸波形的模块。逐指标模型选择相应输入,部分组学资料缺失时仍可预测其他肺功能。这种分层设计使研究能够分别评价可取得的指标,使用范围随数据类型和完整性而变化。
以未处理预测作为同一肺的药物比较参照
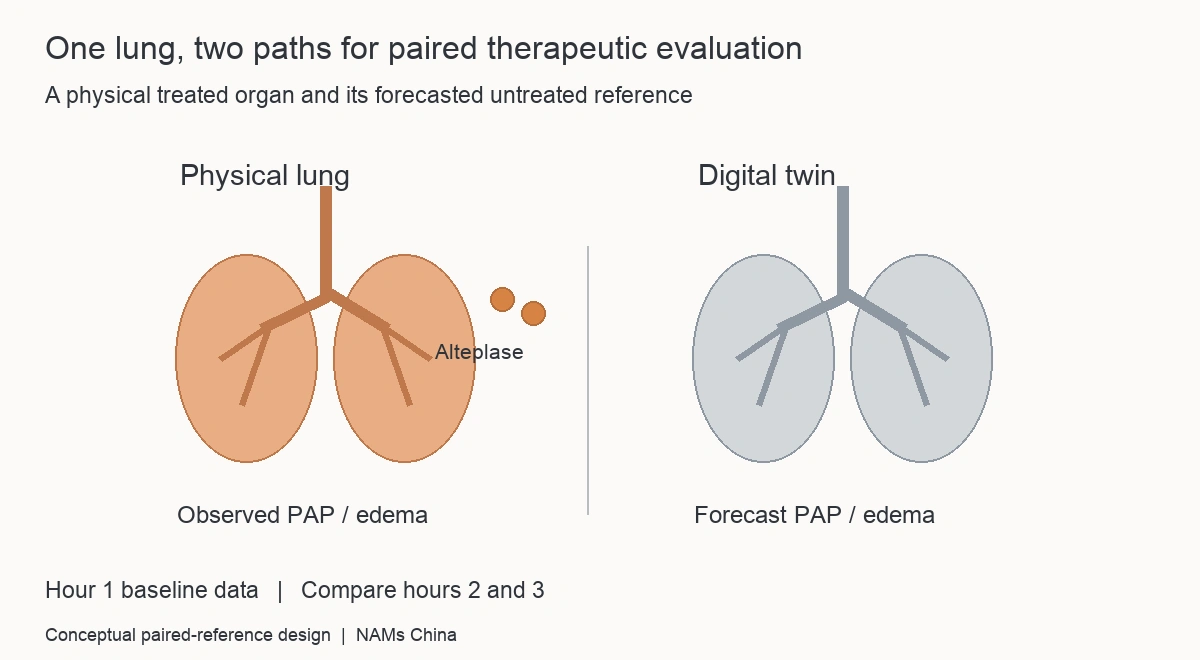
阿替普酶用于处理临床怀疑肺血管栓塞的离体肺。团队先采集第 1 小时的基线资料,再处理实际肺,同时让数字孪生预测其未处理情况下第 2、3 小时的变化。肺动脉压作为主要药效指标,肺水肿估计量用于检查这段时间内的安全性变化。
16 例处理病例中,2 例因灌流不足 2 小时导致资料不完整而退出药物分析,余下 14 例分为 6 例适合移植和 8 例不适合移植的肺。原文依据临床外科评估判断移植适合性,各组的实际测量再与对应数字孪生比较。
在 6 例适合移植的肺中,若采用随机抽取的 6 例未处理肺作传统参照,处理后 1、2 小时的肺动脉压差异均不显著。改用各自数字孪生进行配对分析后,处理后 2 小时的实际肺动脉压低于预测值,P 为 0.031。水肿指标没有显示显著增加。
8 例不适合移植的肺没有出现相同药效:实际肺动脉压与各自数字预测接近或更高,水肿变化也未显著。这一阴性结果说明,个体预测参照可帮助区分处理后的反应,但药物效果仍依赖具体器官状态。
预测时程、数据范围与后续验证方向
数字孪生为同一肺提供了未处理轨迹,研究据此进行短期药效的配对分析。数字参照能否用于这种比较,取决于模型对未处理肺变化的预测准确性。
本研究的数据来自移植前评估场景,部分数据类型的样本较少,模型只覆盖前 3 小时。作者建议继续开展外部验证,并在后续离体肺研究中先保留少量真实对照,再逐步评价能否以数字对照替代。延长预测时间、纳入更多代谢指标及联用多器官系统均属于后续方向。
研究者申报了相关数字模型专利及器官灌流企业利益关系。