
先区分全部文献与进一步核查的模型
美国华盛顿大学(University of Washington)团队在 2015 年发表系统综述,检查基于生理的药代动力学模型(physiologically based pharmacokinetic model,PBPK)怎样建立、用于哪些药物问题,以及作者如何判断模型是否足够可靠。这项工作关注公开研究中的实践差异。
检索限定为 2008 年至 2015 年 5 月 20 日发表、以人体药用化合物为对象的英文文献,共得到 366 篇。其中 271 篇包含原始药物模型,其余为综述、评论或预测方法等文章。在原始论文中,药物相互作用预测占 28%,个体差异与一般临床药代预测占 23%,吸收和年龄相关用途分别占 12% 与 10%。
进一步质量核查聚焦于监管资料列出的敏感底物、抑制剂和诱导剂,覆盖 56 篇论文中的 61 种化合物。纳入模型还须公开足够信息以支持重建,并已与人体观测资料比较。后续质量比例仅描述这个经过筛选的模型子集。
模型参数来自体外资料,也可能经人体数据反推
PBPK 模型把药物性质与人体生理参数分开组织,能够模拟浓度随时间变化。所需输入包括通透性、蛋白结合、清除、器官体积和血流等。模型包含更多器官或参数,可以改善某些曲线拟合,单个参数的可信程度仍受数据和模型结构制约。
在所选模型中,35% 使用体外清除数据,21% 从人体清除数据反推内在清除,18% 直接把体内清除作为输入,17% 使用比例修正,其余 9% 通过参数估计和敏感性分析确定清除输入。相近的最终浓度曲线,可能建立在不同来源和不同假设上。
直接以体内总清除率作为输入,可以帮助描述整体药物消除,但各酶或转运通路尚未拆分。预测酶抑制、诱导或人群表达变化时,需检查模型是否包含相应通路及其贡献。
使用独立数据,还要说明人群是否对应
作者报告,97% 的所选模型与未用于模型建立的独立研究资料进行了比较。比较资料可来自另一给药方案、制剂、人群或药物相互作用研究;57% 的模型使用不止一类资料。独立比较在这个经过筛选的子集中较常见。
但只有 32% 的模型明确报告,模拟人群的年龄、性别和基因型与实际研究对象相匹配;只有 21% 交代模拟的基因型。部分研究可能已经匹配,却没有写清,未报告部分的人群匹配情况仍不清楚。
人群信息会影响器官体积、血流、蛋白结合和酶或转运蛋白水平。同样的平均浓度也可能掩盖不同的人群变异。作者因此建议,同时交代观察人群、模拟人群、研究规模及变异范围,使读者能够判断比较的对象是否对应。
接受标准应预先确定,并符合具体药物用途
56% 的所选模型没有预先说明怎样判定预测成功。其他模型使用的标准也不同:有的要求平均暴露或峰浓度落在观察值的 2 倍以内,有的要求差异小于 25%–30%;还有模型比较的是相互作用引起的倍数变化,该指标描述相互作用前后的相对改变。
这些指标回答不同问题。预测某一条件下的暴露是否接近,与预测另一药物加入后暴露改变多少,需要分别评价。标准还应考虑偏差会怎样影响研究决策,以及目标药物允许多大的暴露变化。
在窄治疗窗药物的 12 篇论文子集中,只有 2 篇使用约 30% 差异标准,6 篇没有明确标准,4 篇仍将 2 倍差异视为可接受。这个分布显示标准与用途的衔接并不一致;报告不足也使模型是否达到原定目标更难判断。
组织浓度预测需要说明验证范围
在 271 篇原始模型论文中,作者只找到 13 篇利用模拟组织浓度回答药效或毒理问题。其余完整模型大多仍以血浆浓度过程为主要比较对象。预测组织暴露的能力,需要结合相应药理问题和可取得的验证资料评价。
完整模型可以预测临床难以取样的组织暴露,但这类输出往往更难直接核实。综述列出的实例包括对乙酰氨基酚肝毒性、尼古丁脑受体占有和替莫唑胺脑内暴露等既有模型;这些例子来自综述所引的既有模型研究。
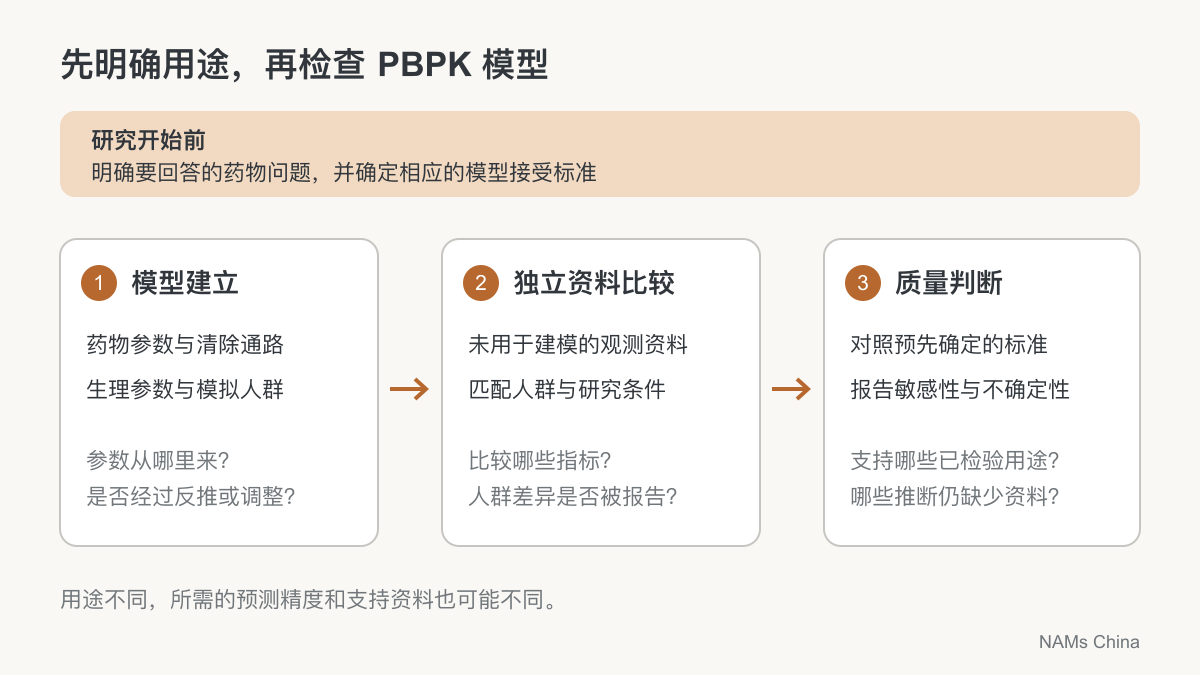
作者在报告建议中要求说明模型目标、参数来源、估计参数的生理合理性、独立比较资料、预先接受标准、敏感性和不确定性。最后还要交代哪些用途已被检验。模型在某个条件下得到支持,后续推断仍应与相应资料范围一起解释。
这项调查反映截至 2015 年的公开文献,检索词、语言和药物类别均有限制。它呈现了当时建模与验证实践的差异;判断具体药物模型的质量,仍需核对该模型本身的目的、数据与比较结果。