
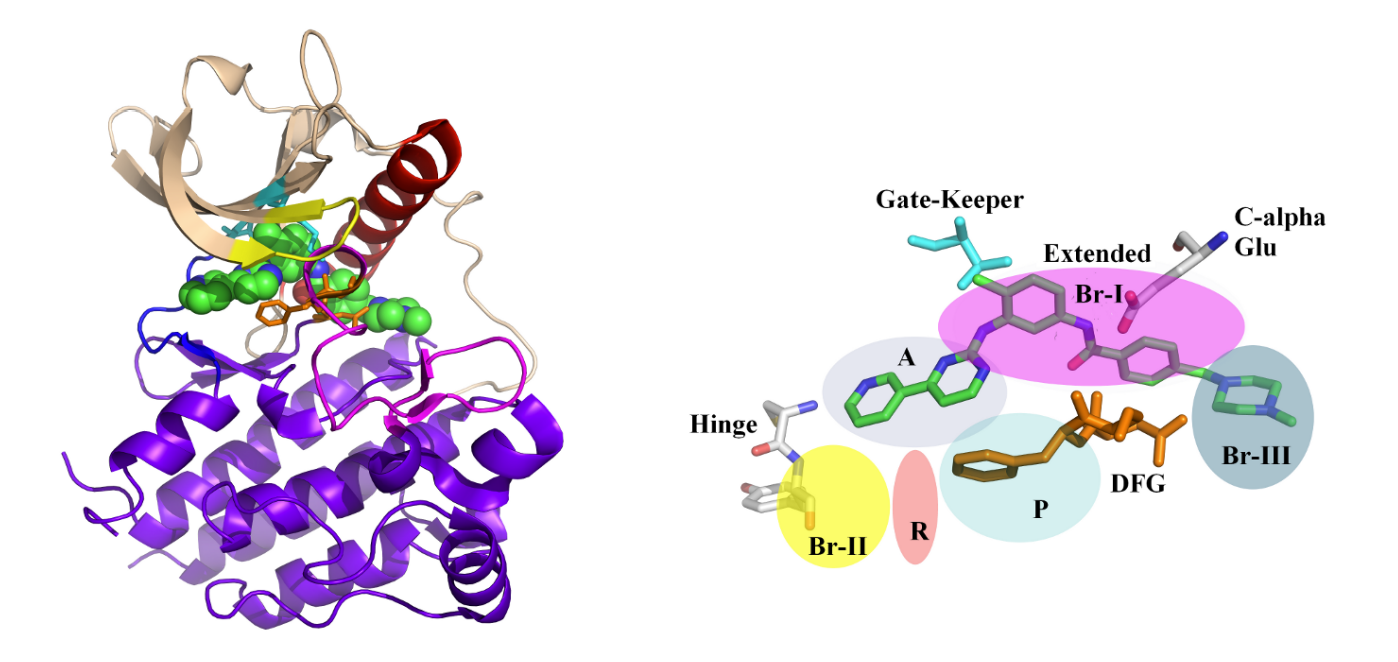
模型同时读取结合口袋和药物三维结构
激酶抑制剂筛选需要比较药物与不同蛋白的结合。美国佐治亚理工学院(Georgia Institute of Technology)团队在 Nature Machine Intelligence 提出 KDBNet,将激酶口袋和小分子各自的三维结构输入模型,预测两者的结合亲和力。
模型用图神经网络(graph neural network,GNN)分别学习蛋白与药物的结构。蛋白图的节点对应氨基酸残基,药物图的节点对应原子;空间距离、接触及相关属性参与信息传递,随后合并为亲和力预测。
模型的蛋白输入限定为结合口袋的 85 个残基。团队取得 283 个激酶的口袋结构,其中 281 个能够与参考序列对应;药物三维结构来自 PubChem。口袋定义和代表构象会影响模型实际看到的信息。
测试分别模拟新药物、新激酶和两者都未见过的组合
评价使用 Davis 和 KIBA 两个公开数据集。Davis 提供解离常数(dissociation constant,Kd),数值越低表示结合越强;KIBA 则将不同生物活性测量整合为分数。模型分别处理这些标签,结构资料缺失的蛋白或药物被移出相应数据集。
团队取得几乎全部药物的三维结构,但两个结合数据集中只有约 50%–70% 蛋白具有所需实验结构。公开数据的覆盖和结构过滤共同决定本次评价对象,未覆盖整个激酶组。
训练与测试分别按新药物、新蛋白以及两者均为新对象划分。研究还设置蛋白序列相似性较低的测试,用来检查模型能否处理与训练对象差异更大的激酶。调参使用训练资料中的保留部分,测试集未用于选择超参数。
与只用一维序列、二维分子图或预计算相似性的基线相比,KDBNet 在相关系数和均方误差等指标上表现更好。去掉蛋白或药物的三维信息后,性能下降,支持空间结构在本文任务中的贡献。
另一个比较使用已有蛋白—药物复合物结构的数据。KDBNet 仅输入双方分开的结构,取得与部分直接使用复合物的模型接近的表现。复合物模型能够看到相互作用几何,两类输入的资料要求不同。
预测误差与不确定性的大小分别检查
KDBNet 默认训练 8 个结构相同、随机初始化不同的模型,以预测均值作为亲和力结果,以模型间的离散程度估计不确定性。这部分主要描述模型对未充分学习对象的把握程度。
在 Davis 数据中,按不确定性分组后,不确定性较低的预测通常具有较低误差。该比较检查预测能否正确排序;研究随后进一步检查区间大小是否与真实误差相称。
例如,标称 95% 的预测区间,应在相应比例的测试中覆盖真实值。研究用校准曲线与理想对角线之间的面积衡量偏差,KDBNet 的结果优于所比较的高斯过程基线。
后处理校准在独立保留的验证资料上估计一个缩放因子,只调整不确定性大小,保持亲和力点预测不变。校准进一步降低了区间覆盖偏差,论文把排序质量与区间解释分开报告。
优先补充难判断的组合可以减少训练资料需求
主动学习从 KIBA 训练资料中随机选择 1% 开始。每轮预测尚未使用的组合,再优先加入不确定性较高的组合,重新训练;比较策略包括优先选择高亲和力和随机补充数据。
研究安排 7 轮扩充,使训练资料比例依次达到 10%、20%、30%、40%、50%、75% 和 100%。测试使用药物与蛋白均为新对象的划分,观察追加哪些资料更能改善预测。
不确定性引导的策略使用约 50% 数据时,已达到接近全部数据训练的表现,初期改善尤其明显。研究用已有测量标签模拟逐步扩充训练集,由模型决定先加入哪些组合的结果。
寻找更多强结合组合与优先选择少量候选采用不同评分
研究将亲和力与不确定性合成评分,模拟两类筛选。希望尽量找全强结合组合时,评分鼓励探索高亲和力但尚不确定的区域;希望优先验证少量候选时,则偏向亲和力高且不确定性低的组合。
在 Davis 的探索比较中,模型从约 1% 组合开始训练,逐步读取已有测量结果。在论文设置的 10000 个组合池中,模型查看约 1000 个组合的测量结果后,找到前 500 个强结合组合中的约一半。
优先候选比较检查各方法推荐的前 10 个组合。新蛋白或新药物划分中,KDBNet 所选组合的平均 Kd 低于 0.5 μM;双方均为新对象时约为 3.5 μM,表现仍受预测对象与训练资料距离影响。
讨论还报告用 AlphaFold 预测结构替代部分实验结构后取得相近准确性,并提出继续改进低覆盖资料、计算效率及校准技术。当前比较使用公开结合资料,输入仍需对应可用结构。