
先明确模拟问题,再建立个体模型
发表于 npj Systems Biology and Applications 的这篇观点文章,讨论免疫数字孪生(immune digital twin,IDT)如何用于复杂疾病和药物研发。它以计算模型表示个体患者的状态,并随着实际数据进入而更新,模拟结果再供研究者或临床人员判断。持续反馈是这一概念的核心。
免疫反应涉及分子、细胞、组织与全身状态,时间尺度也从很短的信号变化延伸到长期疾病过程。作者建议从具体用途出发,选择需要描述的免疫环节和测量尺度,再决定模型需要多复杂。全面重建整个免疫系统是更远期的目标。
机制模型与机器学习承担不同任务
机制模型把已知的细胞调控和相互作用写入计算框架,机器学习则从较大数据集中识别规律。观点文章讨论将两者整合,使模型既能利用生物学知识,也能吸收组学、成像或临床数据中的信息。
训练资料的人群构成会影响模型对新患者的适用性。作者指出,一些算法只在规模较小、构成相近的人群中训练,容易过拟合。迁移学习、保留本地数据的协作训练,以及利用机制知识补充数据,都是文中讨论的改进方向。
两类模型的整合仍有实际障碍。许多生物学知识以定性关系描述,而计算模型需要能用于模拟的形式;怎样把这些知识纳入模型、如何检验预测,仍需要相应的方法与数据。
肿瘤与类风湿关节炎是作者提出的用例
在类风湿关节炎场景中,作者设想用模型描述关节组织细胞与免疫细胞的相互作用,研究滑膜炎症、软骨破坏和骨侵蚀。一个重点是解释传统治疗无反应者的差异,并探索新的干预组合。
文中建议结合细胞内调控网络与基于智能体的多细胞模型:前者描述细胞内的调控关系,后者表示细胞之间及其与周围环境的相互作用。成像、组织损伤指标和患者随访信息可为个体模型提供输入。
肿瘤用例则考虑癌细胞、免疫细胞和基质细胞之间的关系,并计划将活检分型、影像、循环肿瘤相关指标和药代信息结合起来。作者把这两类用例称为范式,重点说明目标和实施思路,完整的患者级系统仍需进一步建立。
从靶点假设到人源实验检验
针对早期药物发现,文章提出几类用途:识别靶点及其组合、选择最有助于检验假设的实验体系、寻找已有药物的新用途,以及把药代和安全性问题纳入治疗模拟。不同任务需要不同的模型功能和数据来源。
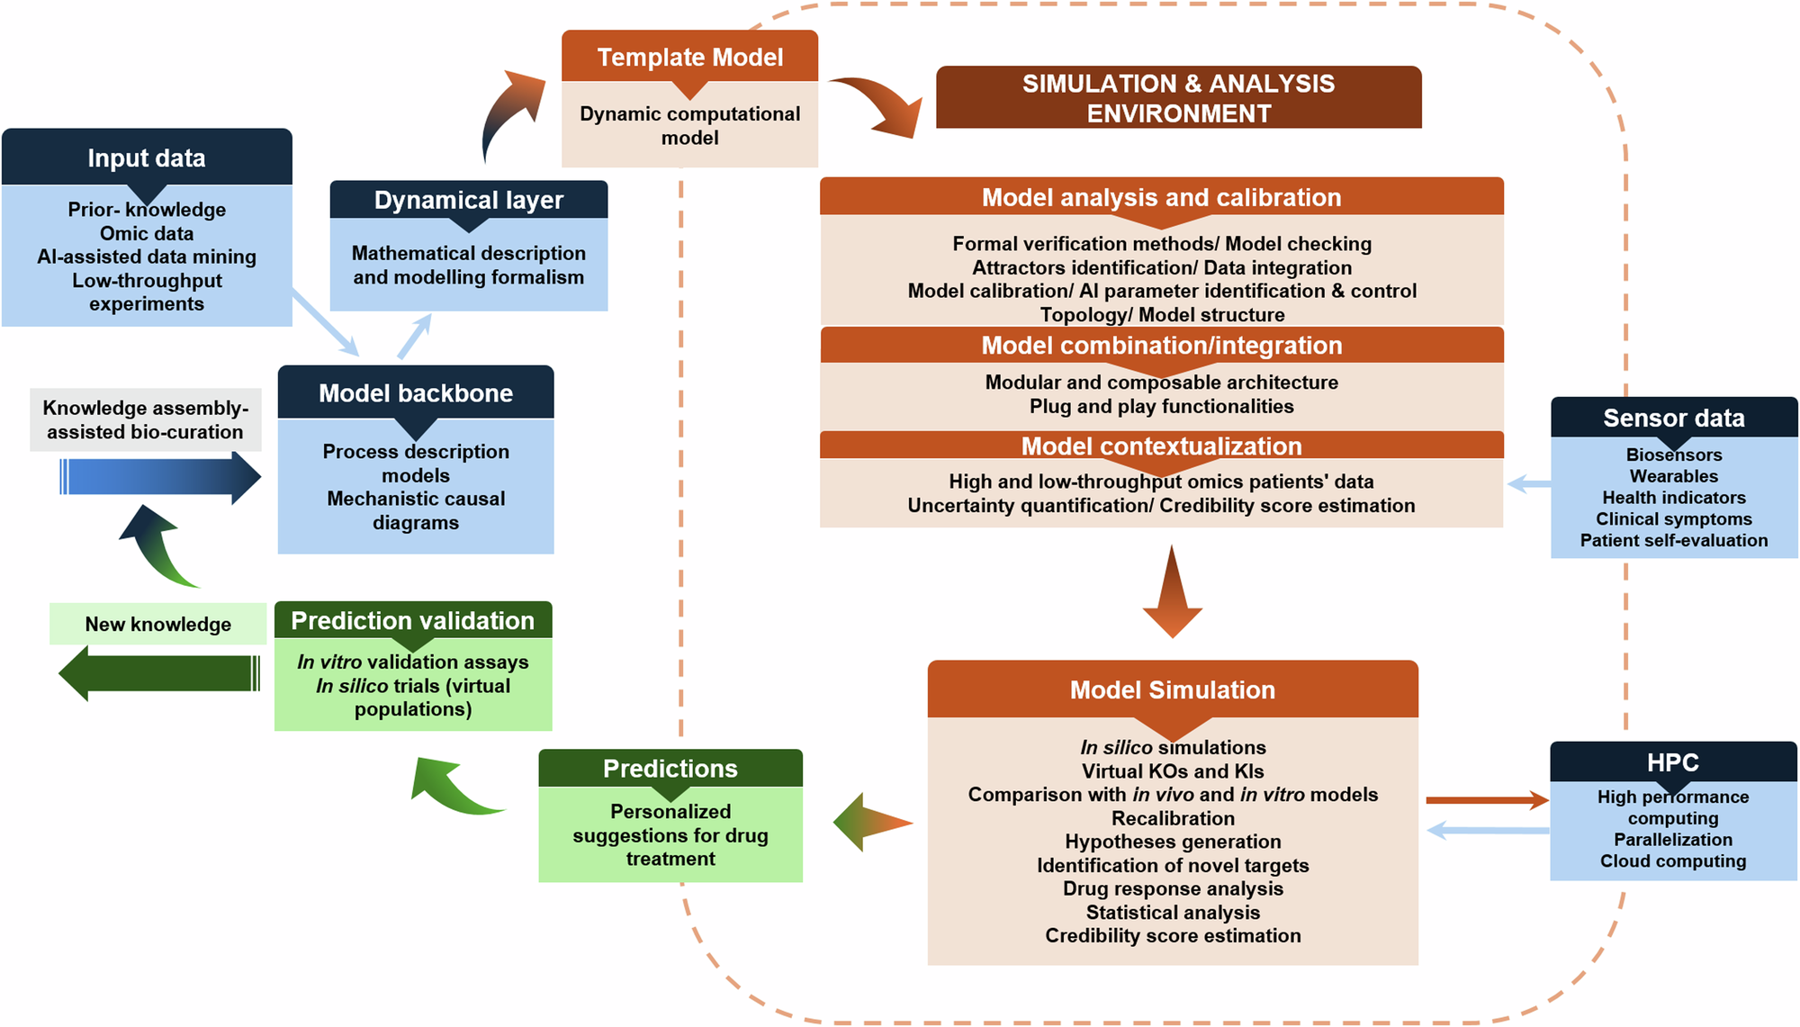
模型可用于候选方案排序,也可以帮助选择细胞系、类器官或实验设计。文章的工作流程将已有知识、组学和实验数据纳入计算模型,再以人源细胞体系等体外实验和虚拟人群研究检查预测,并把新结果用于下一轮修订。
跨尺度模型还要处理敏感性分析和不确定性量化:哪些输入或模型条件更影响预测,观测不足又会给结果带来多大不确定性。观点文章将这些问题列为模型走向实际用途时需要解决的方法学任务。
按这一框架,计算分析可提出待检验的干预假设,实验提供实际反应,模型再据此重新校准。作者设想将数据处理、模拟与实验验证反复衔接,逐步改进对个体治疗反应的描述。
窄屏可横向滑动查看完整图表。
器官表现与分子作用之间仍有缺口
观点文章指出,一些器官级数字孪生主要依据影像、结构或力学特征建立,而药物往往作用于分子和细胞。若缺少两者之间的机制关系,就难以把药物作用转化为器官层面的预测。
反过来,精细的细胞或组织模型也可能只覆盖少数过程,其输出与常规临床测量并不直接对应。作者因此强调,在使用模型之前,应明确它要解释的疾病过程、输出指标及其与实际观测的关系。
模型共享、更新与验证需要共同设计
文章将可查找、可访问、可互操作和可复用作为基础要求。模型及其数据应有清楚的标识与注释,输入和输出应采用适合交换的格式。模块化设计则便于复用已有的模型组件,同时更新与新问题有关的组件。
文中列举的标准包括用于模型交换的 Systems Biology Markup Language(SBML),以及描述模拟实验的 Simulation Experiment Description Markup Language(SED-ML)。但现有标准尚未覆盖所有建模类型,不同尺度的模块还需要解决输入、输出和模型描述的兼容问题。
模型规模还要与问题和计算资源匹配。作者提出在不同复杂度下比较结果质量和资源需求,并重视数据偏差、隐私及使用权限。