
样本重要度衡量一条数据对模型学习的贡献
德国慕尼黑工业大学(Technical University of Munich)团队在 Journal of Chemical Information and Modeling 研究高通量筛选(high-throughput screening,HTS)的数据取舍。目标是找到更多活性分子、排查初筛假阳性,并判断哪些阴性记录应留在训练集中。
数据重要度描述一条样本对模型预测的贡献。论文比较基于近邻的 Shapley 值和 CatBoost,也比较强化学习数据估值(Data Valuation using Reinforcement Learning,DVRL)、梯度下降追踪(Tracing Gradient Descent,TracIn)及最小方差采样分析(Minimal Variance Sampling Analysis,MVS-A)。这些算法利用邻域、树模型、训练反馈或梯度变化估计样本价值。
同一算法还可评估样本对自身预测或对其他样本预测的影响。初筛假阳性可能特别依赖自身标签才能被模型判为活性,对其他样本的预测贡献则较小。不同评分方向在后续排序中分别处理。
先在一个数据集优化,再用其他数据集比较主动学习
研究整理了 25 个公开数据集,每个包含初筛及部分初筛活性分子的确证结果。其中一个数据集用于比较和优化主动学习策略,随后在剩余 24 个数据集上评价优化后的方案。
主动学习从分层抽取的 1.5% 数据开始,每轮再加入整个数据集的 1.5%。直接活性优先的基线选择模型认为最可能有活性的分子;新策略先估计已测样本重要度,再预测剩余分子的重要度,选择下一批。
每轮加入的是已有初筛标签,研究据此模拟逐批检测。评价指标是累计找到的活性化合物比例,各方法的初始比例与每轮增量保持一致。
MVS-A 与高斯过程回归搭配后,在后续比较的 24 个数据集上取得更好的活性发现结果。高斯过程预测重要度需要更多计算时间;换成较快的 LightGBM 回归后,性能与直接活性优先基线接近。
DVRL 的表现接近随机取样,基于近邻的 Shapley 方法也较弱。作者认为,初始训练集较小和调参负担可能限制了这些算法的表现。
用确证标签检查初筛活性排序
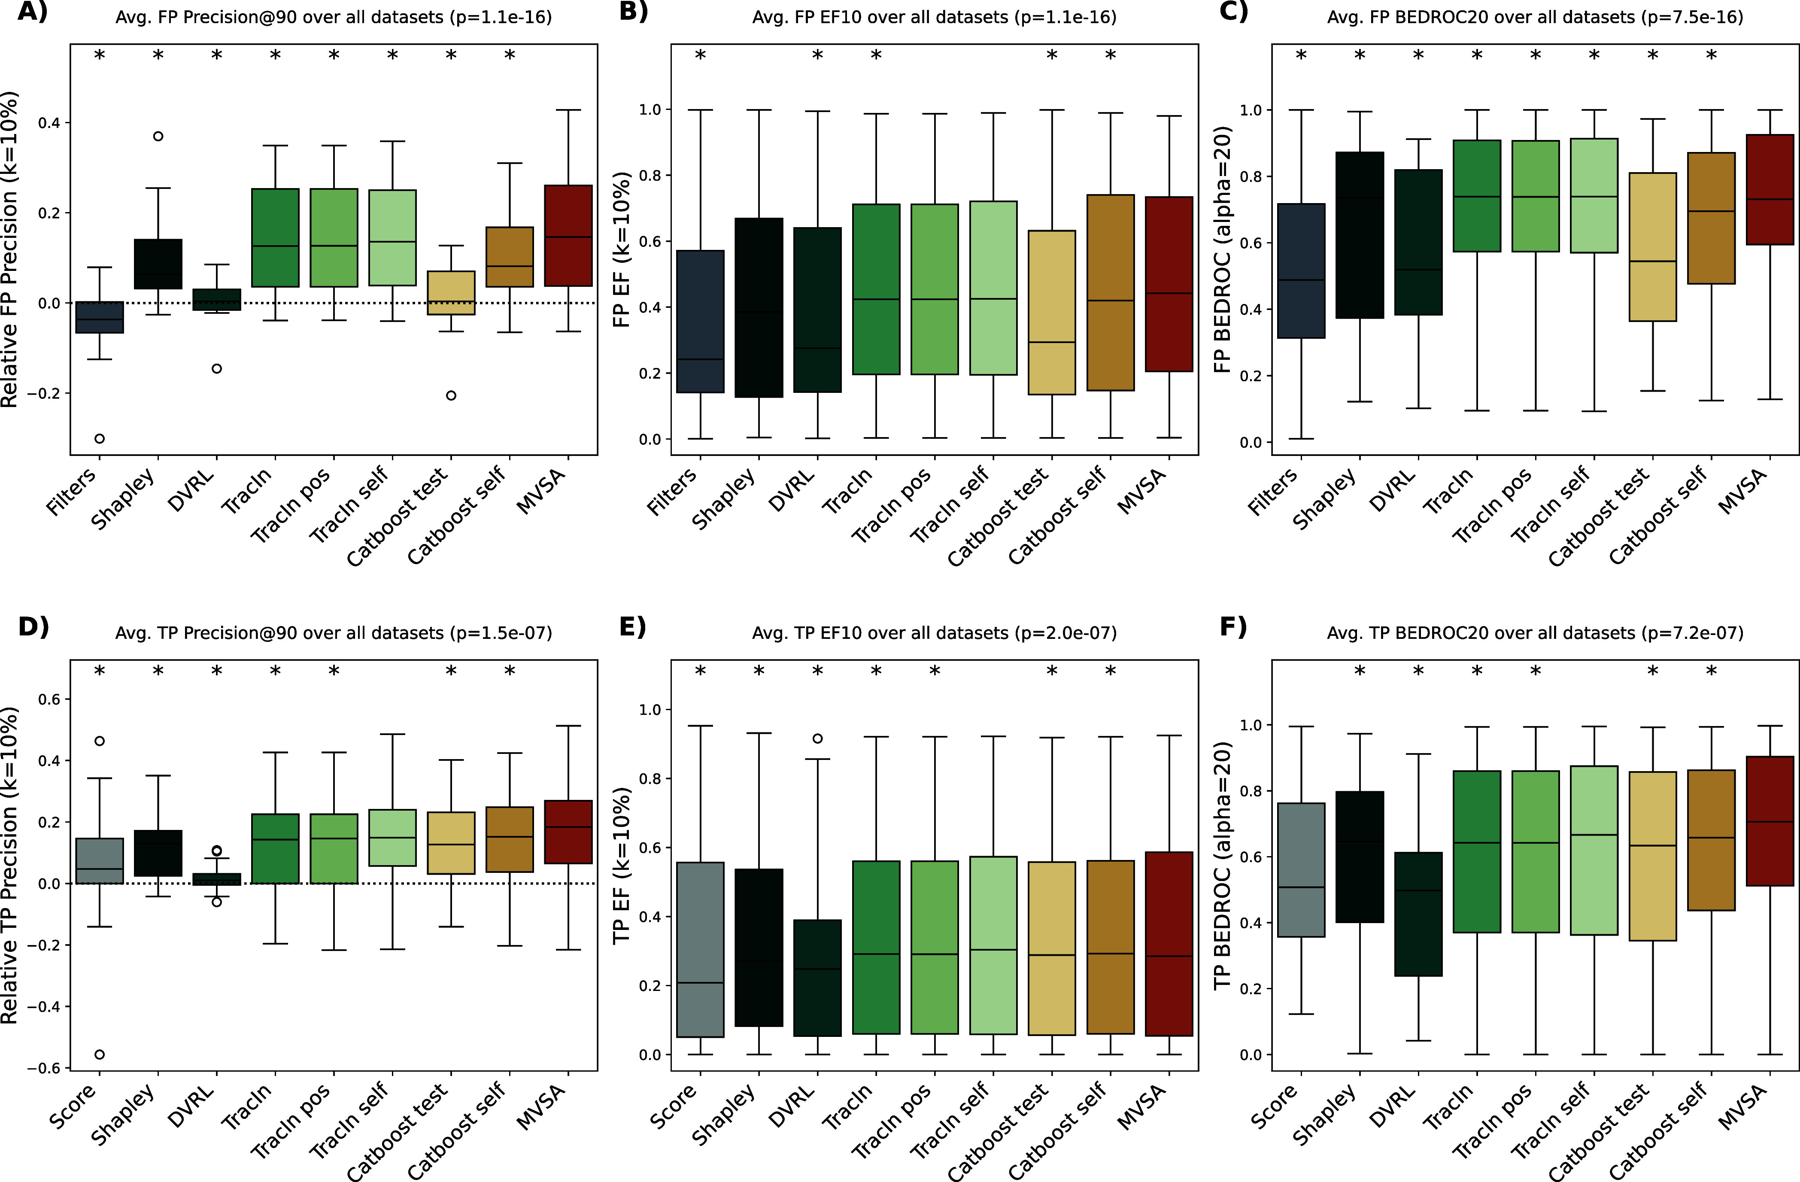
假阳性分析先用初筛训练模型,再根据样本重要度对初筛活性分子排序。评价只使用这些排序分子中具有确证标签的子集,比较前后 10% 的富集表现、精确率和排序指标。
需要独立验证资料的算法,将初筛活性分数最高的 10% 数据留作验证集。初筛分数用于选择这部分资料,已有确证标签则用于评价排序表现。
MVS-A 在假阳性识别的 3 项指标中有 2 项优于其他方法;在富集倍数上,部分 TracIn 方案与其接近。基于预设结构片段的过滤器在本次假阳性任务中较弱,作者同时说明它们还服务于其他药理筛选目的。
真阳性识别则比较样本对其他活性样本的贡献,或反向排除高自身重要度的假阳性。MVS-A 的平均表现较好,但其推荐真阳性分子的结构多样性较低;只按初筛分数排序仍在部分数据集表现最好。
因此,模型识别性能与推荐分子的多样性分别报告。本文的比较覆盖多种生物测量任务,排序的最佳算法和分数方向会随具体数据集改变。
窄屏可横向滑动查看完整图表。
阴性样本对模型边界也有作用
另一组实验使用 MolData 的 10 个老龄相关数据集,保持其既有训练、验证和测试划分。研究逐轮删除原始训练集的 5%,比较随机删减与优先删去高或低重要度的阴性样本。
展示重点为 vitamin_receptor、TNAP、TNAP_phosp 和 HTRA 这 4 个数据集,其基础模型精确率超过 10%。另 6 个数据集的基线表现较低,样本重要度提供的信息不足,未用于同样的重点解释。
删除高重要度阴性样本使分类表现快速下降;保留这些记录有助于模型识别活性与非活性的分界。删除低重要度样本可改善类别不平衡,但没有取得优于随机删减的结果。
这项阴性结果限制了重要度删减的用途:算法能够找到部分关键阴性样本,却未充分区分中等价值与低价值样本。作者提出,可把重要度用于保护关键记录,再配合随机删减。
数据和评价任务共同限定方法适用范围
主要比较使用 1024 位、半径为 2 的扩展连接指纹(extended-connectivity fingerprints,ECFP)作为分子输入,也测试了描述符和字符串表示。研究对不同任务安排相应统计比较与多重检验校正,避免把单个模型的一次排序当作全部性能。
本文分别检验了活性发现、初筛确证和阴性样本保留,量化了预测表现、计算速度与结构多样性之间的取舍。