
药物、手术与器械都进入虚拟人群比较
英国帝国理工学院(Imperial College London)、伦敦国王学院(King’s College London)等团队系统梳理了 2012 至 2021 年的心脏虚拟试验,纳入 36 篇论文。研究用人类患者资料构建计算模型,比较干预前后或不同干预的结果;所涉干预包括药物、手术和植入器械。
药物递送占纳入研究的 17%。综述同时介绍药代和药效群体模型:研究者根据真实临床人群建立参数分布,再采样生成虚拟患者。只在一个代表性细胞模型上测试多种药物的论文被排除,因为没有形成虚拟患者队列。
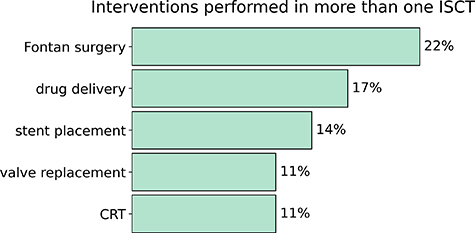
窄屏可横向滑动查看完整图表。
不同研究验证的对象与层次不同
75% 的研究报告了某种验证,但方式不同。有的将模拟结果与患者实测数据直接比较,有的只比较模拟输出的统计分布。综述指出,采用已经过验证的求解器或软件后,仍需要检验整个研究模型。
敏感性分析更加少见,只有 19% 的研究开展了这项分析。作者提出,应逐项报告模型不同层次的验证与不确定性,说明各验证对象和结论。
虚拟人群规模和患者来源需要分别交代
81% 的研究让每个虚拟患者对应 1 位真实患者,规模为 2 至 87 人,平均为 23 人、中位数为 12 人。另有 11% 采用群体模型,虚拟人群可达到数百乃至 12 万个;这些数量来自参数采样,与实际临床招募人数不同。
排除群体模型后,28% 的研究未报告所用患者的基本人口学资料。作者还提醒,在同一批患者资料上增加模拟次数,实际患者来源保持不变;以此扩大的结果数量可能使常规显著性检验失去原有含义。
数据、软件与研究条件影响复现
14% 的研究没有交代所用软件。虽然 89% 的论文可开放阅读,只有 1 项明确提供数据与代码;其他研究多未设数据可用性声明、认为数据存储不适用,或仅表示可向作者申请。
综述建议,最低报告要求应包括患者基本资料、虚拟人群质量控制、不确定性分析,以及更充分的模型和数据共享。作者同时限定,这次检索覆盖 2012 至 2021 年,不能作为整个领域的历史全貌。