
把聚集实验结果作为模型学习的药效指标
剑桥大学(University of Cambridge)及合作者在 Nature Chemical Biology 报道一种计算与实验交替进行的药物发现方法,目标是寻找 α-突触核蛋白(α-synuclein,αS)聚集抑制剂。αS 聚集与帕金森病等疾病有关,本研究重点针对已有聚集体表面促进新聚集的过程,即二级成核。
起始资料来自此前的结构对接与体外验证:68 个可取得的候选中,4 个显示活性。团队随后围绕它们进行结构相似性搜索。较近的 25 个新分子中,有 5 个达到预设效力标准;扩大相似性范围后,符合标准的比例降至约 4%。
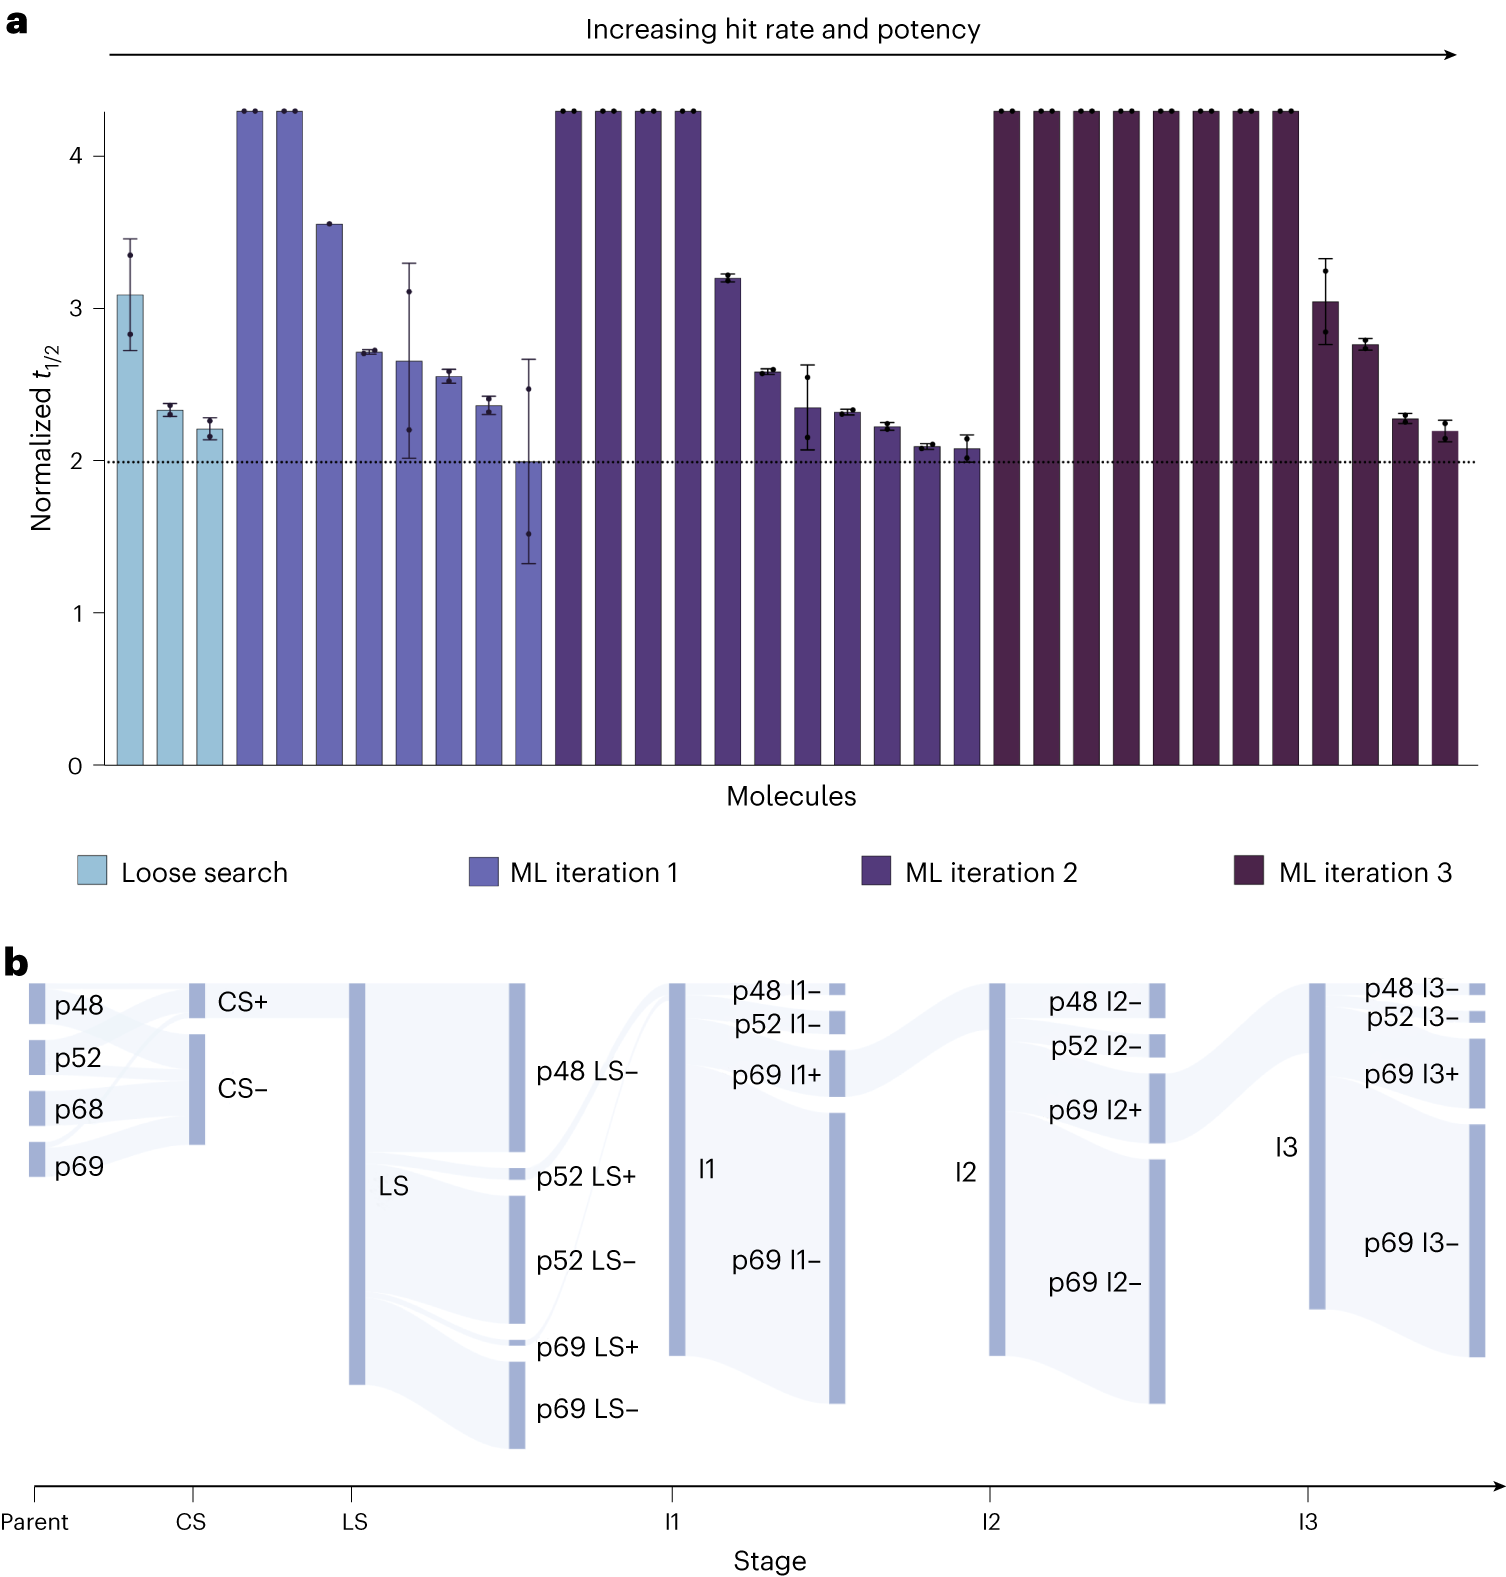
这些实测数据构成 161 个分子的初始训练集。模型学习的主要指标是聚集达到一半所需的时间,记为 t₁/₂;相对于阴性对照,时间延长到 2 倍以上被定义为达到筛选效力标准。这个标准用于当前生化实验中的候选比较。
分子表示与不确定性共同参与候选排序
方法包括三个部分:聚集实验提供效力测量结果,预训练的变分自编码器将分子结构转换为潜在向量,预测模型利用向量和实测效力进行训练。自编码器此前使用约 25 万个分子训练;超出其结构词汇范围的分子会被排除。
团队采用随机森林回归,并用高斯过程拟合其残差。后者带来的预测指标改善较小,但可提供不确定性估计,帮助排序同时考虑预测效力和可信度。不确定性惩罚过高时,模型更倾向留在已熟悉的化学空间。
待评价化合物来自 ZINC15 可供应资料中的约 9000 个分子,均与起始结构具有一定相似性。第一轮反复运行模型后选择 64 个候选购买和测试,再把结果加入训练。前 3 轮分别测试 64、64 和 56 个分子;第 4 轮改用较低浓度的既有数据继续优化。
新候选的聚集抑制与直接结合分别得到检验
迭代获得的分子在较低浓度下仍能延长聚集时间。代表候选 I4.05 的动力学抑制指标 KIC₅₀ 为 0.52 μM,95% 置信区间为 0.45–0.59 μM。起始分子 69 和对照 Anle-138b 的相应外推值为 18.2 μM 和 36.4 μM,比较限定在本研究的检测体系。
上述动力学浓度—效应比较在图 2 中标注 3 个重复。筛选中的 t₁/₂ 和拟合得到的 KIC₅₀ 反映聚集进程,表面等离子共振(surface plasmon resonance,SPR)测得的解离常数(dissociation constant,Kd)反映结合亲和力,二者数值不直接互换。独立结合检测使候选作用的解释不只依赖荧光变化。
图 3 比较相似性搜索与前 3 轮学习得到的有效候选,效力图每个条件标注 2 个重复。部分分子在整个观察窗口内完全抑制聚集,图中采用实验持续时间表示其 t₁/₂,实际半程时间尚未测得。候选数量与检测重复数属于不同层级。
表面等离子共振提供了直接结合证据。I4.05 与 αS 聚集体在 pH 4.8 和 pH 8 条件下的 Kd 分别为 68 nM 和 13 nM,图 4 标注 2 个重复。它对 β-淀粉样蛋白 42(Aβ42)的聚集抑制和结合均不明显,提示作用具有一定蛋白选择性。
新候选对聚集体延长过程的影响很小。团队根据不同聚集步骤的实测速率,推算可溶性寡聚体的出现时间与峰值,图 2 展示 I4.05 的结果。微流体自由流电泳(μFFE)的代表性比较则采用 I3.02,观察到寡聚体数量和大小下降。两类结果提供机制证据,研究尚未测量神经元保护或动物行为恢复。
窄屏可横向滑动查看完整图表。
病理材料检验显示候选排序随检测环境变化
研究还采用路易体痴呆等患者脑组织来源的病理材料,检查候选在不同 αS 结构背景中的效果。新候选仍显示抑制,但效力排序与最初筛选不同;对照 Anle-138b 在部分条件下反而促进聚集。作者提出溶解性可能有关,这仍是解释假设。
方法的优势在于让模型选择和实测效力持续相互校正。其搜索范围仍依赖既有化合物库和起始结构相似性,训练数据较少,预测性能也有限;研究未设置独立的随机采购化合物组。对常见高通量筛选命中率的比较采用文献范围,研究未设置与之匹配的平行实验。
结构相似性限制同时帮助小数据模型减少过度自信,也限定了结果的适用范围。该研究用变分自编码器表示既有分子,随后进行排序采购;生成全新分子的强化学习属于作者另一个项目。当前实测结果支持这个有界化合物库中的迭代选择,推广到更远的化学空间需重新验证。
当前学习主要优化聚集半程时间。作者提出后续增加细胞功能、毒性、药代及神经保护等评价,并进行多指标优化。部分作者与 WaveBreak Therapeutics 存在创办、任职或咨询关系。