
从体外靶点活性推测不良事件,需要哪些信息
人工智能(artificial intelligence,AI)在药物研究中的预测能力,取决于输入数据是否包含所问问题的信息。2021 年,剑桥大学(University of Cambridge)、阿斯利康(AstraZeneca)和欧洲分子生物学实验室欧洲生物信息学研究所(European Molecular Biology Laboratory, European Bioinformatics Institute;EMBL-EBI)的 2 位作者在 Drug Discovery Today 发表综述,讨论药物发现中的生物数据及其标签,重点追问:哪些检测结果能帮助判断药效与安全性?
体外实验能测量化合物对某个蛋白的作用,但人体反应还受到药物暴露、代谢、其他靶点和生物系统状态影响。作者用既有分析说明这一差别:把靶点活性与游离血浆浓度联系起来,再与不良事件记录比较,仍然难以得到靶点作用与临床事件的一一对应关系。
综述中的关联图呈现出两种取舍:有些靶点—事件组合的阳性预测值较高,却只能识别发生该事件的少量药物;扩大识别范围时,假阳性又会增加。因此,靶点活性可为安全性分析提供线索,预测模型还需要纳入与具体体内结局有关的信息。
化合物优选与单个候选的定量预测需要不同数据
作者把常见计算任务分成两类。一类从大量化合物中找出值得进一步测试的候选,通常可以先使用蛋白活性等相对简单的替代指标,作定性优选;另一类要判断某个候选在特定暴露下是否有效、是否产生毒性,需要更复杂的生物学信息和定量结果。
简单检测容易积累大量数据,训练模型也较方便。但如果某项指标与目标体内结局联系较弱,仅增加该指标的数据量,未必能改善药物决策。接近体内药效和安全性的检测往往更难开展,样本较少,标签也更依赖实验条件。选择这两类资料时,需要同时核对数据数量、预测用途和目标终点。
体外到体内外推也需要按具体问题建立关系。同一体外指标在不同化合物系列中,可能受到靶点表达、转运和代谢的不同影响。作者认可针对特定实验与终点的局部外推,同时指出,把这种关系推广到所有药物和所有终点,还缺少相应的数据覆盖。
生物学标签需要保留模型、状态和检测条件
“作用于某个靶点”是常用标签,却可能省略重要差别。同一个基因对应的蛋白剪接形式、活化状态和作用位置可以不同;激动与拮抗也可能带来不同功能结果。只有靶点名称时,计算模型很难据此区分这些生物学过程。
基因表达和细胞成像包含更丰富的信息,但信息量大也带来选择问题。基因表达会随细胞系统、处理时点和暴露条件改变,图像特征则需要说明与哪一种生物效应有关。把高维检测数据转成模型输入时,保留对药研问题有意义的信号,比单纯增加特征更关键。
这些层次之间的联系还需要生物学依据。转录组可以反映基因表达,而某些功能变化发生在蛋白修饰、失活或蛋白相互作用层面。对于同一个药研终点,何种层次的信息最有解释力,需要结合问题判断;技术的可获得性与其对目标功能的解释力需要分别考虑。
病理和临床标签同样依赖背景。作者讨论病理数据时,指出需要结合暴露、所见变化的严重程度、处理组与对照组差异,以及术语是否统一来判断。即使整理的是同一器官,不同记录习惯也会影响资料之间的比较。
综述还区分可记录的实验条件差异与判读造成的噪声。前者有机会通过元数据和合适的模型处理;后者会降低学习到的关系的稳定性。细胞系在培养中发生变化的例子说明,原本视为固定的实验背景,也需要持续记录和检查。
对不良事件数据库,记录还受到患者背景、合并用药、事件频率与严重程度,以及报告偏倚影响。把药物简单标为“有某种副作用”,会压缩这些条件。作者因此要求数据使用者在解释和训练模型时保留背景,避免把记录中的关联直接当作普遍规律。
先确定药研问题,再组织数据与算法
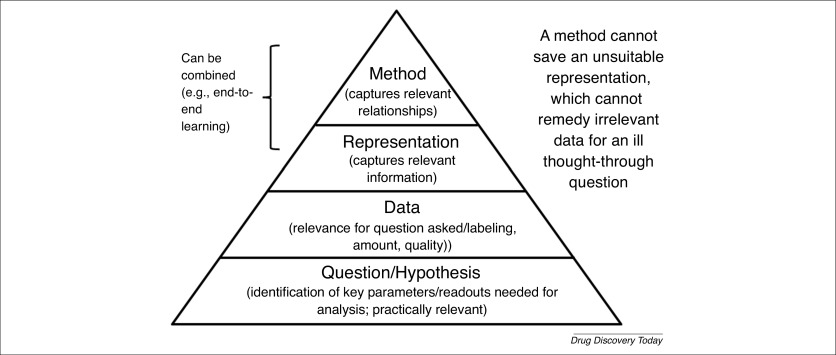
作者用一幅分层示意图组织建模过程:先提出科学问题或假设,再生成与问题相关的数据,选择能够保留信号的数据表示,最后使用适合这些信号的分析方法。这一顺序把算法的用途与实验设计联系起来,也让每一层的不足更容易被辨认。
例如,围绕某项药效假设,可以先用探索性研究判断哪些指标包含相关信号,再扩大这些指标的数据采集。若只是选择容易培养的细胞、固定时点和方便获得的测量数据,随后寻找任意关联,模型所学到的变化可能与目标体内结局相距较远。
作者认为,数据查询、分类归档和近邻检索已有实用价值,这些工作改善了资料的组织与利用。要进一步支持药效与安全性决策,仍需按目标终点选择生物学信息,再用合适的模型加以分析,让预测结果与实际使用的问题保持一致。
窄屏可横向滑动查看完整图表。