
19443 个实验复合物作为药物发现数据基础
德国亥姆霍兹慕尼黑中心(Helmholtz Munich)与慕尼黑工业大学(Technical University of Munich)等团队在 2024 年提出 MISATO(molecular interactions are structurally optimized)数据集,用于结构导向的药物发现模型。它以蛋白质–配体亲和力数据库 PDBbind 中的 19443 个蛋白质–配体实验结构为基础,并保留相应亲和力信息。
训练数据的质量是本文的核心问题。已有结构可能缺少氢原子、原子类型有误或几何构型不合理;亲和力值又来自不同实验方法与条件。作者指出,单凭原始结构和这些混杂标签训练模型,容易把结构误差或测量差异带入预测。
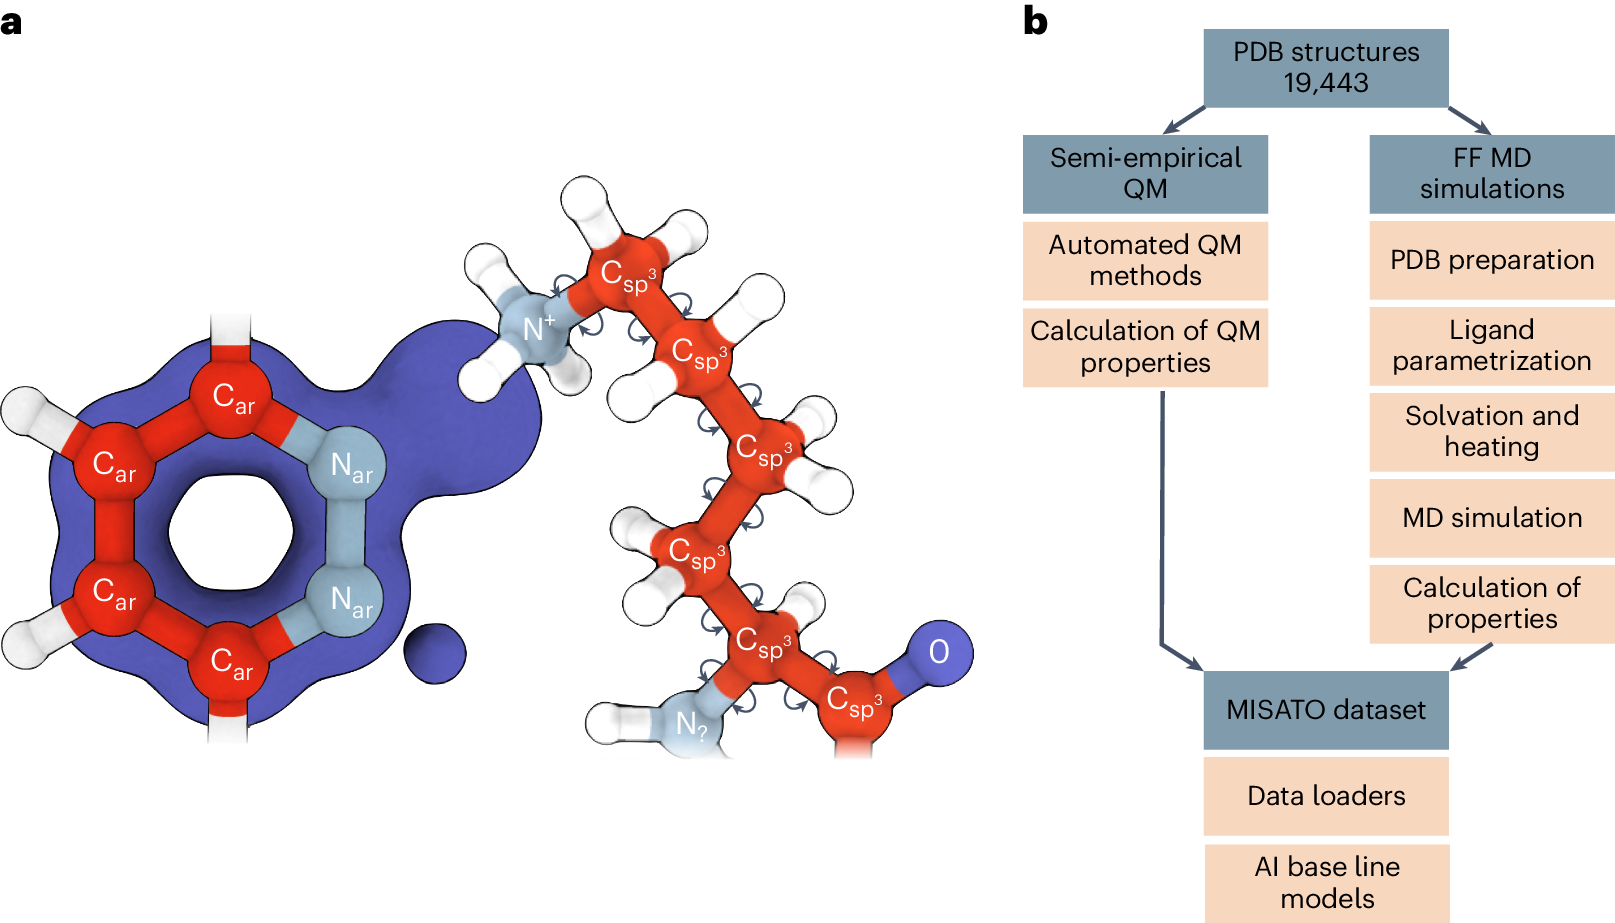
量子化学修正结构,分子动力学补充变化
半经验量子化学(quantum mechanics,QM)计算用于整理小分子结构与电子性质。研究对 3930 个结构作了较大修正,约占原数据库的 20%;主要涉及质子化状态和原子结构问题。对不适合原二元复合物定义或亲和力对象有误的记录,作者拆分、重新检查或剔除。
分子动力学(molecular dynamics,MD)部分为 16972 个复合物生成每个 10 ns 的轨迹,补充静态实验结构缺少的构象变化。起始结构不一致或配体含非标准原子的系统被排除,模拟结果再形成用于学习的动态特征;这些轨迹是计算数据。
窄屏可横向滑动查看完整图表。
基线模型分别预测电子性质和口袋适应性
小分子基线模型预测电子亲和能与化学硬度,两项任务的 Pearson 相关系数为 0.75 和 0.77,平均绝对误差为 0.12 eV 和 0.13 eV。另一模型根据结构预测蛋白质在配体结合时的适应性,平均相关系数为 0.66,最灵活的 100 个原子中平均识别出 42 个。
动态模型学习 MD 轨迹中的变化,量子化学模型学习计算性质。QM 任务还剔除了 30 个目前算法无法正确预测的结构;研究者在实验分组和结果判读时均未采用盲法。
同一蛋白的相对亲和力降低标签混杂
亲和力模型比较同一蛋白、同一种亲和力指标下的配体对,预测两者亲和力之比。数据按蛋白序列聚类后分为训练、验证和测试集,减少相似结构跨集合造成的信息泄漏;高质量亲和力基准专用于测试。
主要基准含 5 种蛋白的 127 个配体,每个蛋白组的数据来自同一篇原始研究。加入 MD 适应性与 QM 电荷特征后,平均 Spearman 相关系数为 0.64;去掉这些特征时为 0.50,Vina 评分为 0.51,采用未经整理的数据库时为 0.50。改善发生在该亲和力基准的 5 个蛋白组中。
第二个基准采用测试集中最大的 6 个蛋白结构簇,组内来源和实验方法更混杂。其绝对相关性下降,但包含 MISATO 特征的模型仍优于对照。作者由此强调结构整理与动态信息的价值,同时保留跨条件亲和力数据难以比较的问题。
计算覆盖仍受分子范围和时间尺度限制
当前 QM 计算只处理配体,MD 时间尺度也较短;作者希望后续扩展计算范围和轨迹时长。