
用人源细胞数据预测大鼠评价指标
2020 年 6 月 12 日,Scientific Reports 发表 IBM Research UK 与英国 Daresbury 实验室团队的机器学习研究。论文将药物处理后的人源细胞基因表达与结构信息结合,预测同一药物处理后的大鼠血尿素氮(blood urea nitrogen,BUN)。
BUN 在本文中作为肾功能异常相关指标,模型输出是连续数值。研究考察能否用较容易获得的体外数据,解释和预测既有动物评价中的一个具体指标。
L1000 表达与结构指纹的匹配输入
团队使用 L1000 基因表达资料,整理 964 个标志基因特征,并加入 166 位结构指纹。前者反映细胞对药物的生物学反应,后者记录分子结构中的信息,这 2 类输入在模型中提供互补信息。
原始表达资源包含不同药物、细胞系和处理条件。作者将表达资料与 DrugMatrix 中相同药物的大鼠 BUN 记录对应,最终纳入 429 种化合物及其匹配测量;最终测试集包含来自 8 种人源细胞系的信息。
各来源的处理背景并不完全相同。作者讨论了人源细胞条件与动物暴露进一步匹配的可能性。
表达与结构整合后的 BUN 预测表现
研究分别以表达特征、结构特征或两者的组合作为输入,使用高斯过程(Gaussian process,GP)回归预测 BUN。在保留测试集上,只使用表达或结构时,R² 分别为 0.013 和 0.028;共同输入后达到 0.418。
普通均方根误差(root mean squared error,RMSE)也由两个单独输入模型各自的 3.708,降至组合模型的 2.961。预测值与测量值的相关性随之改善。
高斯过程另输出每个预测的分布和不确定性。组合输入后,预测分布的平均标准差从 3.283 降至 0.683,降低约 79%,降幅大于普通 RMSE。作者据此强调,误差和预测不确定性可以提供不同信息。
分层降维保留两类特征的差别
组合输入包含 1130 个特征,而数据点只有 429 个,高维与相对少量数据构成建模困难。团队比较主成分分析、截断奇异值分解及分层处理,希望压缩冗余信息而保留预测所需的结构。
分层方法先分别处理结构和表达特征,再把结果合并。论文所选结果为 57 维,其中结构部分 17 维、表达部分 40 维。
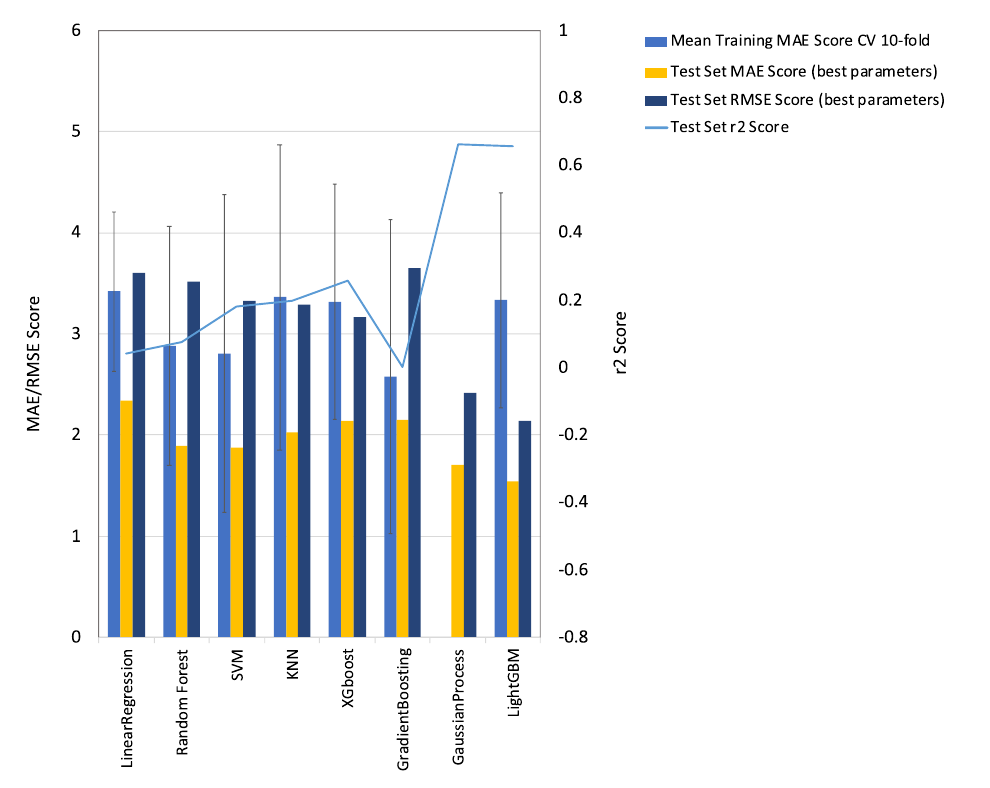
在这一数据集上,分层结果的测试集 R² 为 0.661,相关系数为 0.81。普通 RMSE 为 2.419,按预测不确定性加权的 RMSE 为 1.528。
LightGBM 与高斯过程的误差和不确定性
研究还比较线性回归、支持向量机、随机森林和梯度提升等方法。部分算法在降维后改善,另一些在未降维输入上更好。
LightGBM 与分层高斯过程表现接近:它的测试集平均绝对误差和普通 RMSE 更低,而高斯过程的 R² 略高。高斯过程的另一项特点,是随预测返回不确定性,帮助使用者判断哪些输入更接近训练资料所覆盖的范围。
在一个实测 BUN 为 37.89 mg/dl 的样本中,LightGBM 预测为 34.61 mg/dl,高斯过程预测为 37.23 mg/dl。作者用这一例子展示,两种整体表现接近的模型,对个别样本仍可给出不同结果。
比较不同算法的特征贡献
团队用 ExtraTrees 分析原始特征贡献,表达和结构分别占累计重要性的约 54% 和 46%。
对高斯过程模型,作者从降维空间追溯原始基因特征,其中包括与肾损伤有关的 CCL2、与增殖和存活有关的 FOSL1,以及参与抗氧化防御的 GLRX。
保留测试集检验跨体系预测
研究将 80% 的数据用于训练,其余 20% 作为保留测试集。上述预测结果来自测试集,目标是用人源细胞对药物的反应预测大鼠 BUN,为较早期的安全性筛选提供研究实例。