
结构去重后,不同化合物仍可能产生相同指纹
瓦伦西亚理工大学(Universitat Politècnica de València)Pablo Ferri 与 Juan M. García-Gómez 在 Journal of Chemical Information and Modeling 报道血脑屏障通透性预测中的数据偏倚。研究关注:测试分子与训练分子过于相近时,较高的预测成绩有多少来自这些相似性。
团队合并 MoleculeNet、B3DB、DeePred-BBB、QSAR-BBB 和 NeuTox2 的 27,369 条记录。用 RDKit 处理盐与溶剂片段、电荷和互变异构形式,再按规范化结构去重并删除同一结构的冲突标签,得到 7,845 个化合物。
结构去重仍不能消除所有模型输入的重复。不同规范化结构可能产生完全相同的 ECFP 指纹,称为精确特征碰撞;也可能产生高度相近的指纹,称为近似特征碰撞。研究关注这些相近分子在数据中过度集中所造成的预测偏倚。
从训练集的邻近距离自动确定近似碰撞阈值
研究以 ECFP 指纹的 Jaccard 距离衡量分子特征差异,距离为 0 表示精确碰撞。对于距离较小但不为 0 的化合物,团队没有直接采用固定阈值,而是分析每个化合物与最近邻居的距离分布。
去除精确碰撞后,算法拟合 4 种候选的 beta 分布或混合分布,用带约束的期望最大化算法估计参数,再依据贝叶斯信息准则选择分布。若分布包含近似碰撞成分,便由该成分与普通邻近分布的交点确定阈值。
阈值估计与参数调节只使用训练数据,测试数据在这一阶段留出。30 个随机种子得到的阈值平均为 0.054、标准差为 0.003;这是当前数据与指纹下的结果,换用其他特征或数据集时需要重新估计。
3 种测试集数量与类别比例一致,分子组成不同
团队先按 75%/25% 分层划分训练与测试数据,再形成随机、去精确碰撞、去精确及近似碰撞(ExApr)3 套数据。精确碰撞处理中,同标签化合物只保留第 1 个,标签冲突的化合物删除;测试集还删除与训练集精确碰撞的化合物。
近似碰撞的处理有所不同:同标签的相近化合物只保留第 1 个,标签不同的相近化合物保留,因为这些通透性差异可能提供有效信息。训练与测试之间的近似碰撞也依照标签是否一致处理。
为减少测试规模和类别比例的影响,随机与去精确碰撞测试集按 ExApr 测试集的数量和类别频率重新分层抽样。3 个测试集的组成不同,研究比较的是相同规模、相同类别比例下,不同相似性处理对成绩的影响。
预测模型包括随机森林、梯度提升、前馈神经网络、稀疏编码器、图卷积网络和 ChemBERTa,分别使用分子描述符、指纹、图或 SMILES 输入。超参数通过训练集内的 4 折交叉验证优化;描述符标准化也在划分后完成,避免测试信息进入训练处理。
随机测试集的 AUC 与宏 F1 平均相对增幅超过 10%
论文报告,随机测试相较 ExApr 测试的 AUC 平均相对增幅为 13.3%,宏 F1 平均相对增幅为 16.44%。团队采用 1,000 次非参数自助重抽样计算 95% 置信区间;文中相应性能增幅的区间均未包含 0。
同一模型更换测试集时的成绩变化,比更换输入特征或模型结构时更大。相较之下,使用随机、去精确碰撞或 ExApr 训练集所带来的变化较小。作者据此认为,本研究中的主要影响来自测试集中与训练分子相近的实例。
精确碰撞的影响大于继续去除近似碰撞的增量影响。作者将这一差别与数据中精确碰撞的数量更多联系起来;结果提示,仅按规范化结构去重仍不足以检查模型实际接收到的重复特征。
熟悉骨架中的插值与新骨架上的外推分别评价
研究另外区分 2 类用途。分布内测试要求测试分子的骨架已出现在训练集中,接近围绕既有先导骨架优化分子的任务;骨架留出测试让训练与测试的 Bemis–Murcko 骨架互不重叠,用于评价对新骨架的外推。
分布内随机测试的 AUC 常超过 0.95。去除精确和近似特征碰撞后,分布内 ExApr 的 AUC 为 0.770–0.857、宏 F1 为 0.702–0.773;骨架留出测试的相应范围为 0.699–0.818 和 0.567–0.697。
作者提出,ExApr 与骨架留出各自回答不同问题:前者检查熟悉化学空间中的预测是否依赖相近化合物,后者检查模型能否推广到新的结构骨架。两类成绩应结合实际候选筛选或先导优化用途解释。
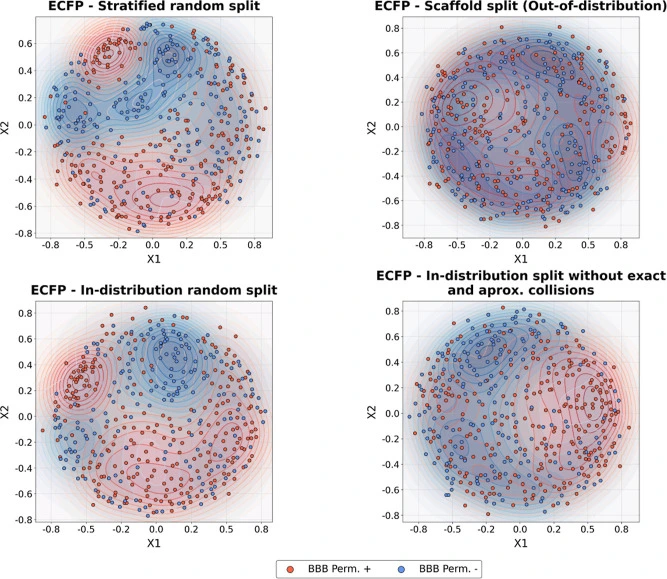
窄屏可横向滑动查看完整图表。
二维特征与公开数据库分布限定了结果的用途
这里的通透性标签反映跨越血脑屏障的综合结果,混合了被动扩散和转运体等影响。ECFP 使用二维结构表示,对三维构象和立体差异的描述有限,预测仍受到这些结构因素的影响。
作者也保留了另一种可能:特征碰撞有时来自有效的特征提取,并不必然表示模型只在记忆训练化合物。如果这些表示仍能提取可推广的规律,不同碰撞处理后的测试成绩应更接近。
公开数据库的可通透分子比例高于许多实际筛选任务,实际使用时的预测精确率还会随类别比例变化。这项工作是既有数据上的模型评价,没有新增化合物的脑暴露实测;将同一偏倚处理扩展到其他药物性质,是作者提出的后续方向。