
1,955 个分子的标签与类别不平衡
美国 Phillips Exeter Academy 与 Northwestern University 的作者在 International Journal of Molecular Sciences 发表血脑屏障(BBB)分类研究。团队使用 MoleculeNet 的血脑屏障穿透数据集(BBBP),将分子结构转为指纹和理化描述符,再比较多种监督学习算法。
整理后的数据包含 1,955 个分子,其中 1,492 个为 BBB 阳性标签,463 个为阴性标签,约为 3∶1。作者以多数类别分类的简单模型作参照:它的准确率已达 76.3%,因此还需要观察错误落在哪一类。
论文研究的是数据库中的穿透标签,模型没有加入主动转运蛋白或显式的多种离子化状态。作者将分析重点放在与被动扩散相关的分子描述符上。
交叉验证均值与单次划分结果分开呈现
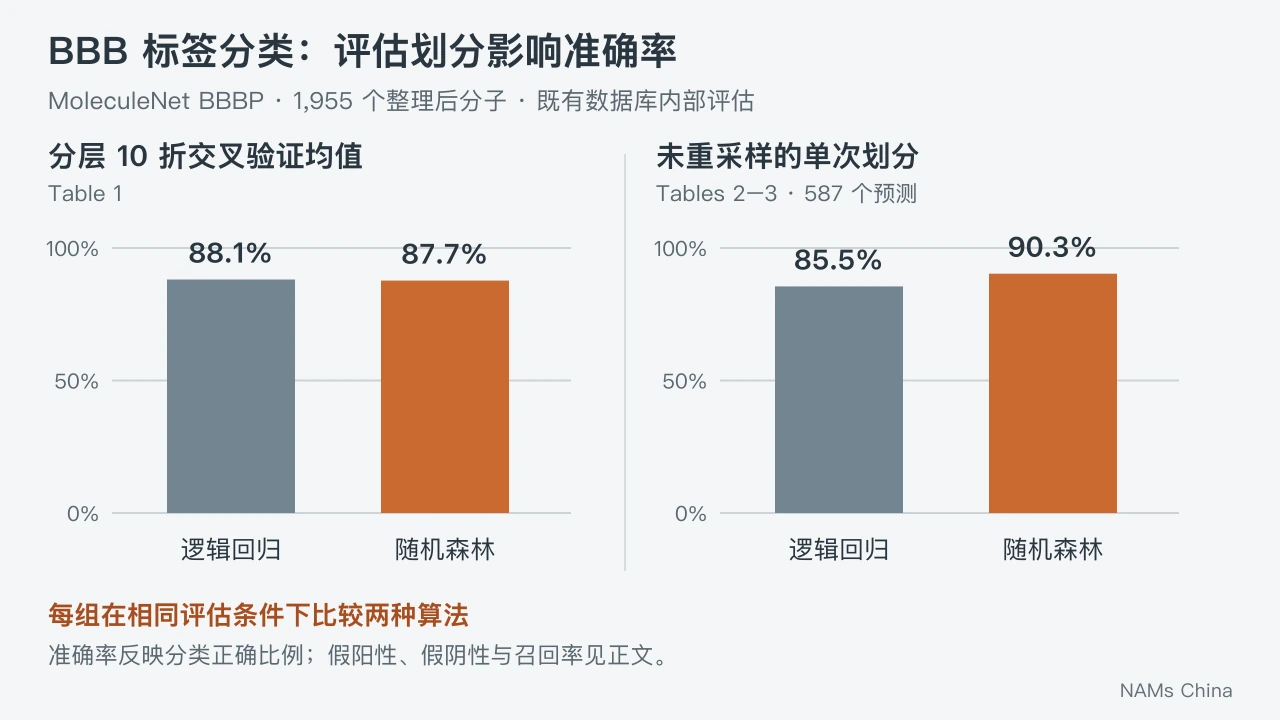
基准比较使用分层 10 折交叉验证。逻辑回归的准确率为 0.881,精确率与召回率的调和均值 F1 分数为 0.925;随机森林分别为 0.877、0.924。这组均值中,2 个简单模型的总体表现相近。
另一组单次划分结果显示,未重采样随机森林的准确率为 0.903,逻辑回归为 0.855。随机森林在该次划分中产生 5 个假阴性和 52 个假阳性,逻辑回归分别为 28 个和 57 个。这里的假阴性指把 BBB 阳性分子分为阴性。
单次划分表与交叉验证表对应不同评估。前者能够展示一次具体分类的错误构成,后者概括分层折内表现;论文尚未用新的化合物来源检验预测能力。
重采样减少部分错误,同时改变召回率
作者比较合成少数类过采样技术(SMOTE)、侧重边界样本的过采样及联合欠采样。合成样本仅在训练折内生成。逻辑回归加入 SMOTE 后,单次划分的假阳性由 57 个降至 46 个,假阴性则由 28 个增加至 39 个。
随机森林的变化较小:SMOTE 后准确率由 0.903 升至 0.906;联合欠采样使精确率由 0.895 升至 0.911,召回率则由 0.989 降至 0.955。采样策略改变了保留候选分子与排除阴性分子之间的取舍。
氢键供体计数与分类困难区域相关
随机森林的重要特征包括氢键供体(NH/OH)计数和氮、氧原子总数。图中的分组统计显示,NH/OH 计数为 0 时,分类准确率约为 94.0%;计数为 3 时约为 67.9%。这是该数据及模型的分组表现,作者据此讨论极性与脂溶性共同影响穿透的可能性。
计数较高的组以阴性分子为主,分类准确率又有所回升。因而作者观察到的计数为 3 的困难区域,需要结合类别构成和其他分子特征解释。特征重要性提供了相关线索,研究没有通过改变这些基团的配对实验验证因果作用。
当前结果用于内部模型比较
作者提出,后续可加入分子相似度和预测不确定性,检验训练范围之外的化学结构;按化学骨架划分数据或测试新合成分子,也是进一步验证的方向。当前结果提供数据库内的算法比较和特征分析。