
从实验数据建立分类与脑血浓度比模型
美国空军研究实验室(Air Force Research Laboratory)等机构研究者在 NAM Journal 报道一项血脑屏障计算预测研究。团队用 B3DB 实验资料建立分类模型,判断化合物能否进入脑;另用有连续数值的子集预测 LogBB,即脑与血液浓度比的对数。
原始数据库包含 7807 个有分类标签的分子,其中 1058 个同时有 LogBB。团队先清理混合物、无机物和不适用结构,再标准化二维表示并去重。
最终分类数据为 3968 个分子,其中 2447 个标为可穿透、1521 个标为不可穿透;有连续 LogBB 的子集为 917 个。采用二维特征意味着部分立体异构体被合并,模型也相应保留这一信息范围。
5 折验证与骨架划分分别检验不同预测条件
团队比较随机森林、梯度提升和图神经网络,使用结构键、分子指纹或理化描述符,建立 7 个分类模型。多模型结果再通过多数投票形成综合分类。
评价采用 5 折交叉验证,以及按分子骨架分开训练和测试的方案。后者把相同骨架放在同一集合,以检查模型面对未参与训练的骨架时的表现。
原始分类中可穿透分子约占 62%,多数模型更容易判对这一类别。团队只在训练过程中调整类别平衡,保持同样的测试集合,使平衡前后的结果能够直接比较。
平衡训练改善不可穿透类别,模型分歧另行保留
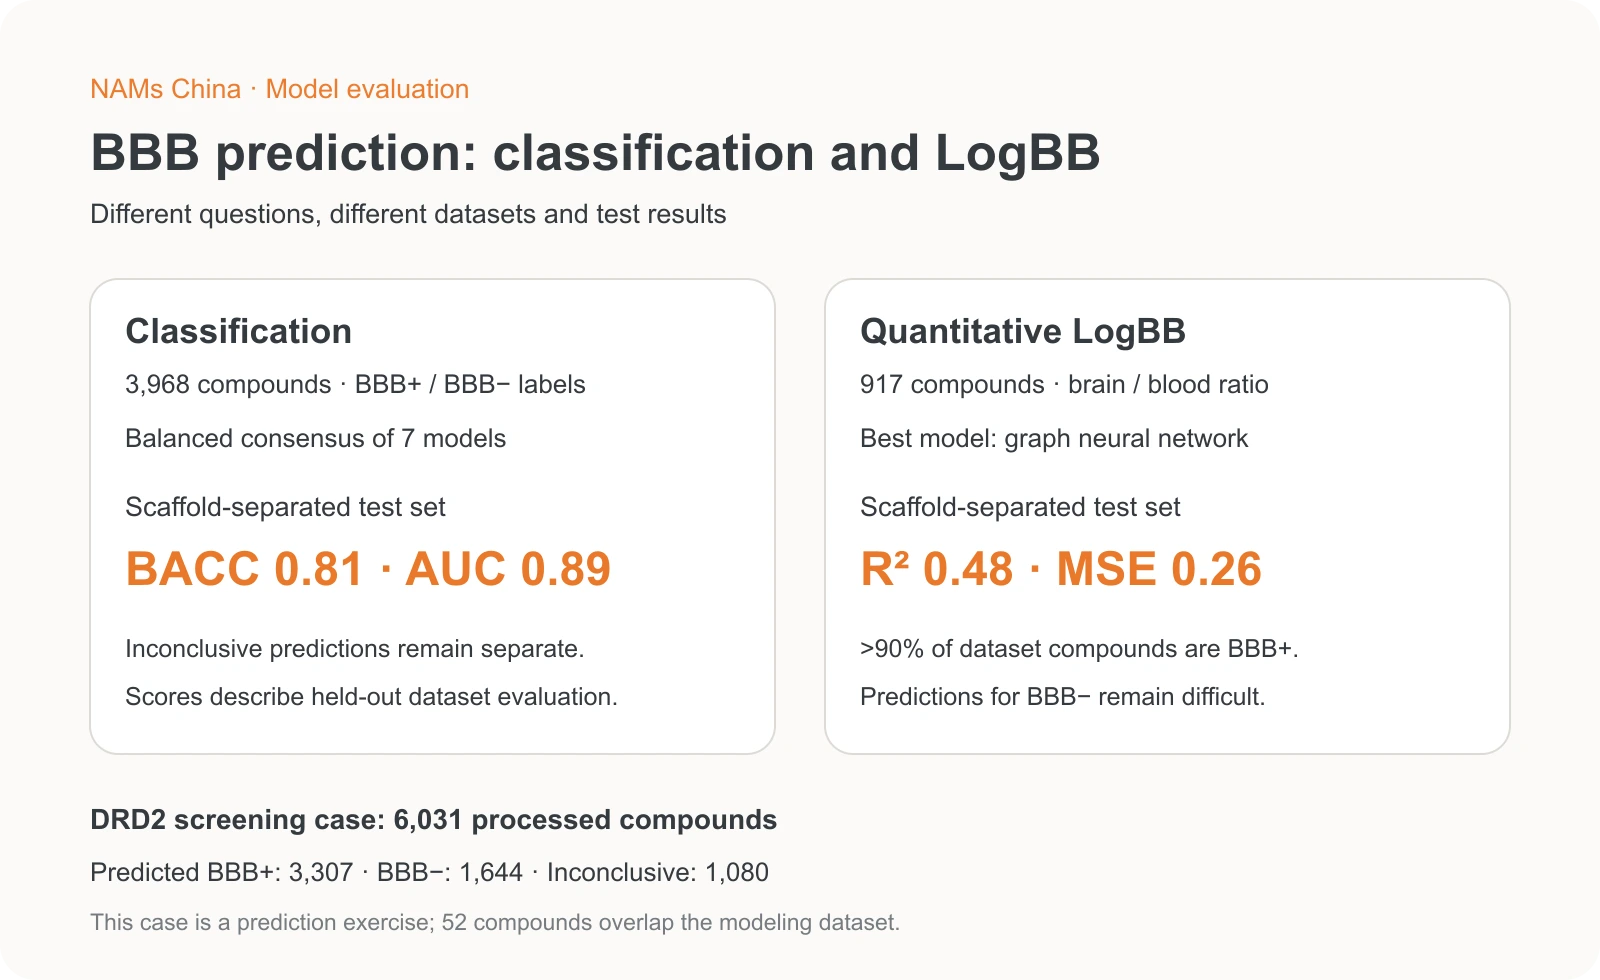
平衡后的综合分类在骨架划分测试中,平衡准确率为 0.81,ROC 曲线下面积为 0.89。5 折验证中的相应指标为 0.80 和 0.89;敏感度与特异度之间的差距缩小。
团队进一步用 7 个模型是否一致评估预测可信度。4 比 3 的分裂结果标为不确定;至少 5 个模型一致的结果进入论文定义的适用范围。
只评价模型适用范围内的分子时,敏感度和特异度提高,但一部分测试分子被排除。骨架划分中有 97 个、约 12% 的测试分子没有得到明确分类,性能与被覆盖的分子比例需要一起看。
连续 LogBB 预测受到少数类别不足的限制
917 个连续值分子中,超过 90% 被标为可穿透。研究只用骨架划分比较回归模型,最好结果来自图神经网络,测试集 R² 为 0.48,均方误差为 0.26。
把多个回归模型平均并未进一步改善成绩。该数据集中极低或极高 LogBB 较少,不可穿透分子尤其不足,模型容易把这类分子预测为可穿透。
作者提出先用分类模型筛选,再在预测可穿透的子集中用回归模型估计程度。该两步安排是论文的应用建议,连续预测的成绩仍来自现有数据划分,尚未用新增实测分子验证。
结构解释描述数据库中的预测关联
SHAP 分析把较低的拓扑极性表面积列为多个模型的重要预测特征,电荷、脂溶性及部分杂环相关描述符也参与判断。不同特征的作用方向随模型而变化。
另一项分析识别出 88 个与可穿透标签关联的片段,覆盖约 45% 的可穿透分子。该分析仅对包含相应片段的分子提供信息,覆盖范围与分类性能各自有限。
这些解释来自数据库标签和模型关联。真实脑暴露还涉及主动转运、外排和代谢;实验方法、结构表示和数据分布影响预测,作者把计算结果用于优先安排后续体外或体内评价。
6031 个受体筛选分子获得 3 类预测结果
团队从 PubChem 获取已在多巴胺 D2 受体拮抗筛选中显示活性的分子,整理后保留 6031 个。模型将其中 3307 个预测为可穿透、1644 个预测为不可穿透,1080 个标为不确定。
不可穿透预测约占 27%,可帮助调整中枢靶点候选的后续验证顺序。该应用集合中有 52 个分子与建模数据重叠,所报的已知分子判断成绩来自这 52 个已参与建模的分子。
本次应用主要给出预测清单,未新增这些候选的脑浓度实测。作者强调,结构去重、类别平衡、模型分歧和适用范围应共同纳入筛选流程,后续仍需按药物暴露与生物活性确认。