
31 项研究按模型输入分为 3 类
美国 Rensselaer Polytechnic Institute 团队在 Discover Artificial Intelligence 发表血脑屏障(BBB)预测综述。文献检索于 2025 年 1 月 22 日进行,最初找到 584 项记录,筛选后纳入 31 项使用计算模型预测 BBB 穿透的研究。
作者按输入信息组织模型:一类先计算理化描述符与分子指纹,一类将分子转成图或图像,另一类处理简化分子线性输入规范(SMILES)字符串。不同表示方式决定模型需要预先计算什么信息,以及如何学习分子结构。
常用数据集的共同来源与标签偏倚
综述介绍 BBBP、bbbp_martins 和 B3DB 等常用数据集。BBBP 与 bbbp_martins 对应版本分别约有 2,052 个和 2,030 个分子,2 者共享早期文献数据来源,处理和质量控制后保留数量不同。
作者指出,这些资料的标签来自不同研究与判定条件,阳性分子占比较高。某些早期数据还将中枢活性与穿透联系起来。共同来源和标签条件差异会影响跨数据集比较,分子数量相近也需要结合这些条件解释。
预训练又使用更大的结构数据库,让模型先学习一般分子信息,再在较小 BBB 数据集上调整。预训练资料的规模与 BBB 标签质量是不同层次的问题,作者因此建议发展更统一的实验数据和外部测试。
描述符模型提供解释,分子图模型学习邻近结构
描述符模型先提取分子量、极性、氢键和结构指纹等信息,再交给随机森林、支持向量机或梯度提升模型。作者认为这类输入较易解释,在较小数据集上也能取得较好表现;其覆盖范围受预先选定特征限制。
分子图模型把原子或子结构作为节点,把化学键作为边,并通过邻近节点交换信息来学习表示。图像模型则从分子结构图中提取特征。这些模型减少了手工指定特征的需求,但训练和预训练条件会影响结果。
综述列出的某个消息传递模型,验证集的受试者工作特征曲线下面积为 0.960,测试集为 0.709。作者用这一差异讨论过拟合及泛化问题。模型性能比较需要同时说明原研究的数据划分、预训练与测试条件。
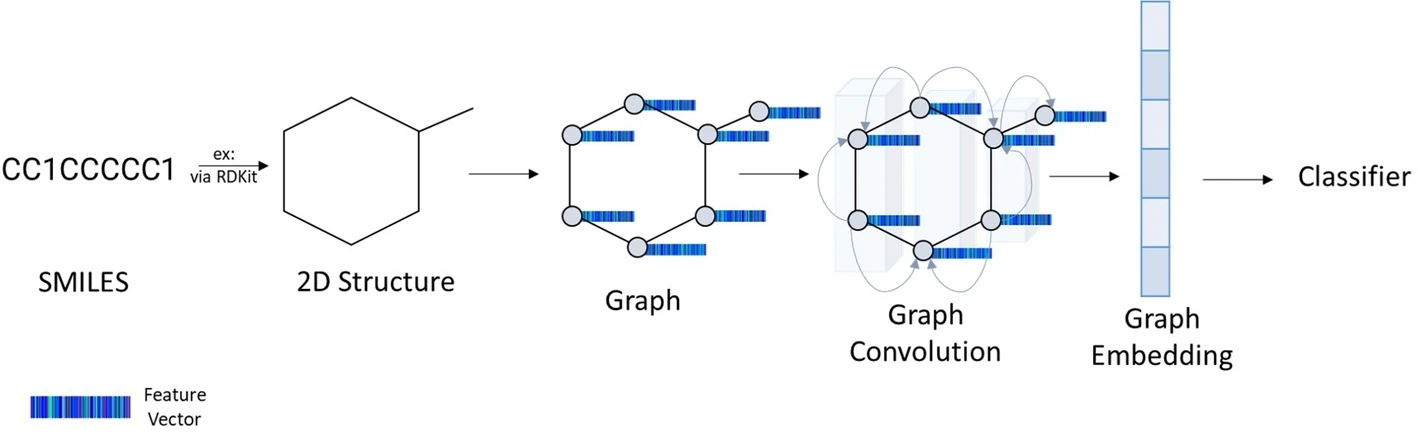
窄屏可横向滑动查看完整图表。
字符串模型仍需结合数据和实验终点评价
字符串编码模型将 SMILES 拆成序列,学习用于分类的向量。综述中,相关模型采用不同编码、预训练和融合策略;作者总体上认为其表现仍有改进空间,并提出把描述符、结构信息与字符串表示结合。
纳入的 1 项研究另对 27 个分子进行体外检测。作者将这一例子与主要依赖数据库内部验证的其他研究对照,强调实验测试和跨数据集验证的价值。
模型比较需要说明分子来源和实际划分
文中的性能表同时列出数据来源、训练/验证/测试数量或比例,以及代码可用性。不同研究使用的划分、预训练和指标并不统一,因此比较需要保留这些条件,尤其要分清同库测试与来自新来源的外部检验。
这篇综述提供的选型信息主要是输入表示、数据需求与验证问题。作者的跨模型比较仍受文献异质性限制,后续目标是获得更一致的标签、更多样的分子和更充分的实验验证。