
4 种算法与 6 种采样策略组成 24 个模型
加拿大 McMaster University 与 Queen’s University 团队在 B3clf 中检验一个具体问题:当血脑屏障通透数据的阳性与阴性数量不同,重采样能否改善分类?模型预测小分子的通透或不通透标签,并输出相应概率。
团队以 B3DB 血脑屏障数据库的 7,807 种分子为起点,去除带电或无法生成有效三维结构的分子后,筛选阶段保留 7,407 种,包括 4,855 种通透阳性和 2,552 种阴性。后续描述符计算又因软件不兼容剔除 5 种分子。团队从 1,875 个分子描述符中去除异常、常量和高度相关特征,保留 475 个用于建模。
比较包括决策树、k 近邻、逻辑回归和极端梯度提升(XGBoost)4 种算法。每种算法分别采用不重采样、随机欠采样、合成少数类过采样(SMOTE),以及边界型 SMOTE、聚类型 SMOTE、自适应合成采样(ADASYN),得到 24 种组合。
训练折重采样,经过 2 轮交叉验证选择参数
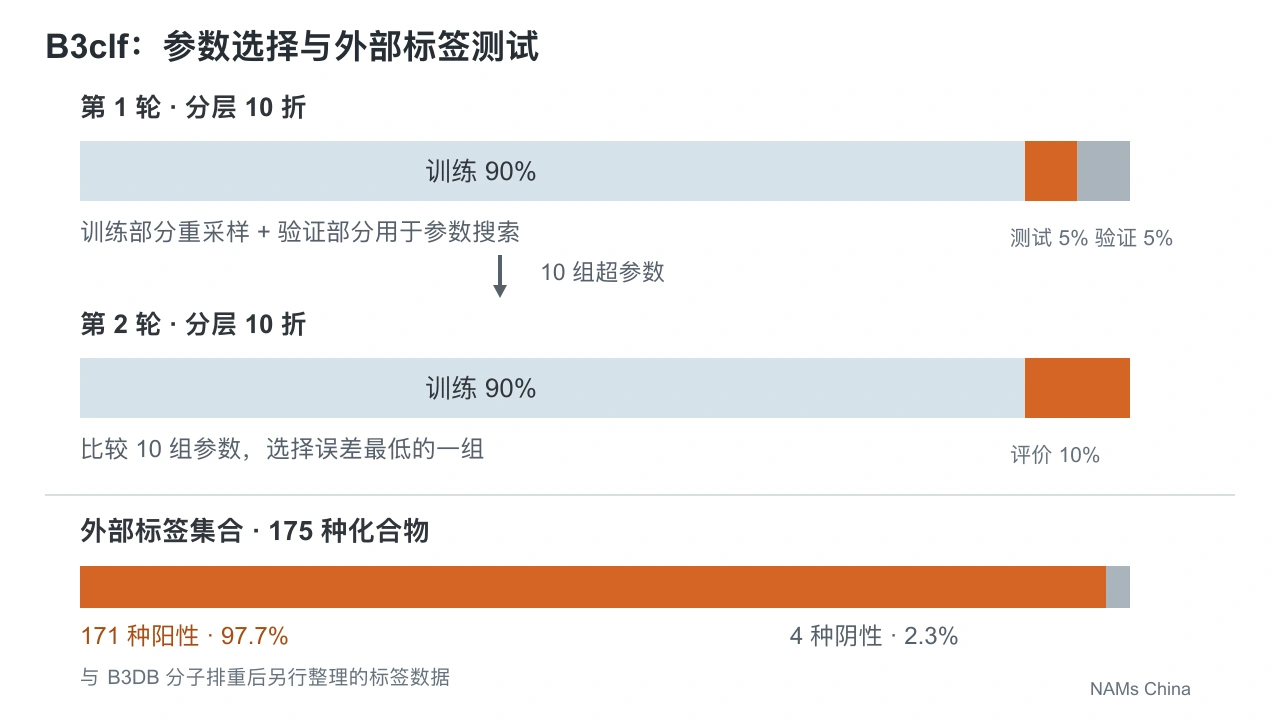
第一轮分层 10 折划分中,每折 90% 数据用于训练,另外 10% 均分为测试和验证部分。重采样只处理训练部分,验证数据参与超参数搜索;每轮得到 10 组超参数。第二轮再以 90% 训练、10% 评价,比较这 10 组参数,选择误差最低的一组。
在交叉验证比较中,XGBoost 与 ADASYN 的组合取得受试者工作特征曲线下面积(ROC-AUC)0.9585 ± 0.0048,敏感度 0.9275 ± 0.0121,特异度 0.8233 ± 0.0180,准确率 0.8916 ± 0.0083。这些指标分别描述排序、识别阳性、识别阴性和总体分类结果。
重采样的收益随算法和指标变化:XGBoost 的不重采样版本已具有较好的表现,部分过采样组合带来有限改进;随机欠采样可提高对阴性的识别,却可能降低对阳性的敏感度。作者据多项指标选择组合,单一采样策略没有在所有算法和指标上持续领先。
外部测试有 171 种阳性与 4 种阴性
作者另外整理 175 种化合物,来源包括按药物分类选取的中枢神经系统药物、H1 抗组胺药,以及因脑通透性较差而停止临床开发的化合物。与 B3DB 重叠的分子和单原子物种被排除。最终标签中,171 种为阳性,4 种为阴性。
这组外部测试中,XGBoost–ADASYN 的平均精确率(AP)为 0.9993,准确率为 0.9086,敏感度为 0.9064,特异度为 1.0。决策树与边界型 SMOTE 的 AP 更高,为 0.9997,但准确率为 0.8114。较高的排序指标与较高的总体分类正确率分别回答不同问题。
阴性标签只有 4 个,特异度 1.0 在本组中对应这 4 个阴性均被正确分类。AP 的解释也要连同阳性占比考虑;这组数据适合检验已有通透药物的识别,却仍需更多阴性及覆盖更广化学空间的外部测试。作者还指出,部分比较模型曾在训练中使用这组外部数据中的约 40–60 种化合物,模型间比较因此需注意训练重叠。
分类工具保留概率输出,数据与阈值仍待完善
B3clf 接收分子结构文件或线性分子结构字符串(SMILES),生成并优化三维结构,再计算描述符,返回通透标签及概率。作者用特征贡献分析解释模型中重要的电子拓扑、氢键和自相关描述符;这些是模型利用的关联特征。
作者指出,B3DB 混合了不同实验方法、条件和质量的数据,标签噪声仍可能影响模型;本研究也尚未优化各模型的分类概率阈值。后续需改善原始测量的一致性,并检验阈值调整对敏感度和特异度的影响。
本文采用 2025 年 8 月 20 日的 ChemRxiv v1 预印本,尚未经过同行评审。